

Wielkość efektu – jak liczyć, interpretować i raportować w pracy
Wielkość efektu to liczba, która mówi, jak duża jest różnica między grupami albo jak silny jest związek zmiennych – niezależnie od tego, ilu osób było w badaniu. Typowe pytanie z pracy dyplomowej: promotor pisze „brak wielkości efektu” – którą miarę wybrać do mojego testu i jak ją opisać?
W prostych słowachWartość p odpowiada na pytanie „czy wynik da się łatwo wyjaśnić przypadkiem?”, a wielkość efektu – „jak duża jest różnica?”. To dwie różne informacje i w pracy potrzebujesz obu. Do każdego testu jest pasująca miara: przy teście t – d Cohena, przy ANOVA – eta kwadrat, przy chi-kwadrat – phi albo V Cramera. Najlepiej podać ją razem z przedziałem ufności.
Dlaczego wartość p nie mówi o sile efektu?
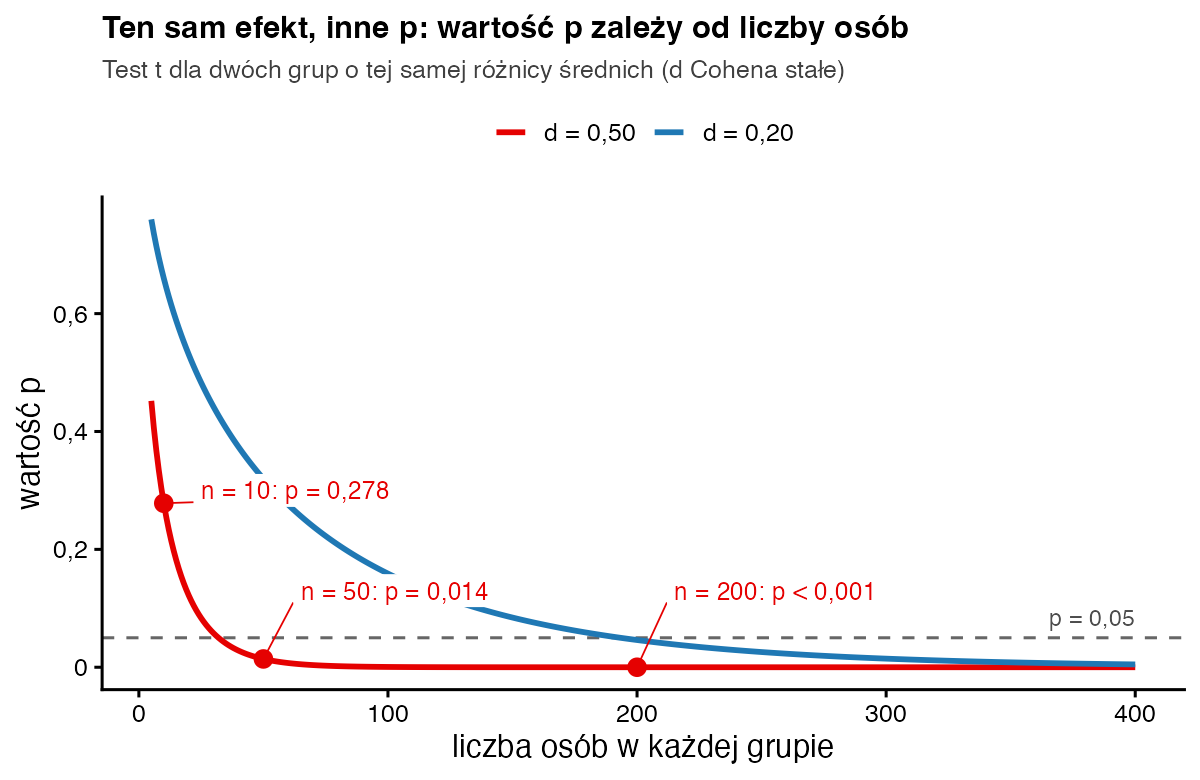
Wartość p zależy jednocześnie od wielkości efektu i od liczby osób. Ten sam efekt może więc dać wynik nieistotny w małej próbie i bardzo istotny w dużej. Weźmy dwie grupy różniące się o pół odchylenia standardowego (d = 0,50, efekt średni). Przy 10 osobach w grupie test t daje p = 0,278, przy 50 osobach p = 0,014, a przy 200 osobach p < 0,001. Efekt jest ciągle taki sam, zmienia się tylko pewność, że nie jest przypadkiem. Działa to też w drugą stronę: przy 2000 osobach w grupie nawet pomijalna różnica d = 0,10 daje p = 0,002. Dlatego Amerykańskie Towarzystwo Statystyczne przypomina, że p nie mierzy wielkości efektu ani jego znaczenia (Wasserstein i Lazar, 2016), a standard APA 7 wymaga podawania miar efektu obok testów (American Psychological Association, 2020).
Miary wielkości efektu – tabela z progami
Wybór miary zależy od testu. Progi Cohena (1988) są umowne. Pomagają nazwać efekt, ale zawsze porównaj go też z wynikami podobnych badań. Wzory i przykłady liczone ręcznie znajdziesz w hasłach słownika podlinkowanych w ostatniej kolumnie.
| Miara | Kiedy jej używać | Mały | Średni | Duży | Wzór i przykład |
|---|---|---|---|---|---|
| d Cohena | test t: dwie grupy albo dwa pomiary | 0,20 | 0,50 | 0,80 | d Cohena |
| g Hedgesa | jak d, z poprawką dla małych grup | 0,20 | 0,50 | 0,80 | g Hedgesa |
| r | korelacja; testy U i Wilcoxona (r = z/√N) | 0,10 | 0,30 | 0,50 | r w testach rangowych |
| η² | jednoczynnikowa ANOVA | 0,01 | 0,06 | 0,14 | eta kwadrat |
| ω², η²p | ANOVA: ostrożniejsze oszacowanie, plany złożone | 0,01 | 0,06 | 0,14 | cząstkowe η² i ω² |
| φ | chi-kwadrat w tabeli 2×2 | 0,10 | 0,30 | 0,50 | współczynnik phi |
| V Cramera | chi-kwadrat w większych tabelach (progi dla df* = 2) | 0,07 | 0,21 | 0,35 | V Cramera |
| OR | tabela 2×2, regresja logistyczna | 1,68 | 3,47 | 6,71 | iloraz szans |
| R² | regresja liniowa (progi f² przeliczone na R²) | 0,02 | 0,13 | 0,26 | współczynnik R² |
| W Kendalla | test Friedmana | 0,10 | 0,30 | 0,50 | W Kendalla |
| Progi według Cohena (1988); dla OR według Chena i in. (2010); dla W zwyczajowo przejęte od r. Przy V dla tabel z df* = 1 progi są takie jak dla φ. | |||||
Kilka wskazówek przy wyborze. Gdy w grupach jest mniej niż około 20 osób, zamiast d podaj g Hedgesa, bo d lekko zawyża efekt. Przy ANOVA η² mówi, jaką część zmienności wyjaśnia czynnik, a ω² robi to ostrożniej. W planach z kilkoma czynnikami programy podają cząstkowe η², więc zawsze napisz, którą wersję wybrałeś. Przy testach rangowych nie licz d Cohena, tylko r. Pamiętaj też o kierunku: d i r mogą być ujemne, a znak mówi, która grupa miała wyższe wyniki albo czy związek jest dodatni.
Cztery przykłady na tych samych danych co w słowniku
Liczby pochodzą z małych zbiorów, na których pokazujemy wzory w hasłach. Każdy wiersz to inny test i inna miara.
| Zbiór | Test | Wielkość efektu [95% CI] | Jak to opisać |
|---|---|---|---|
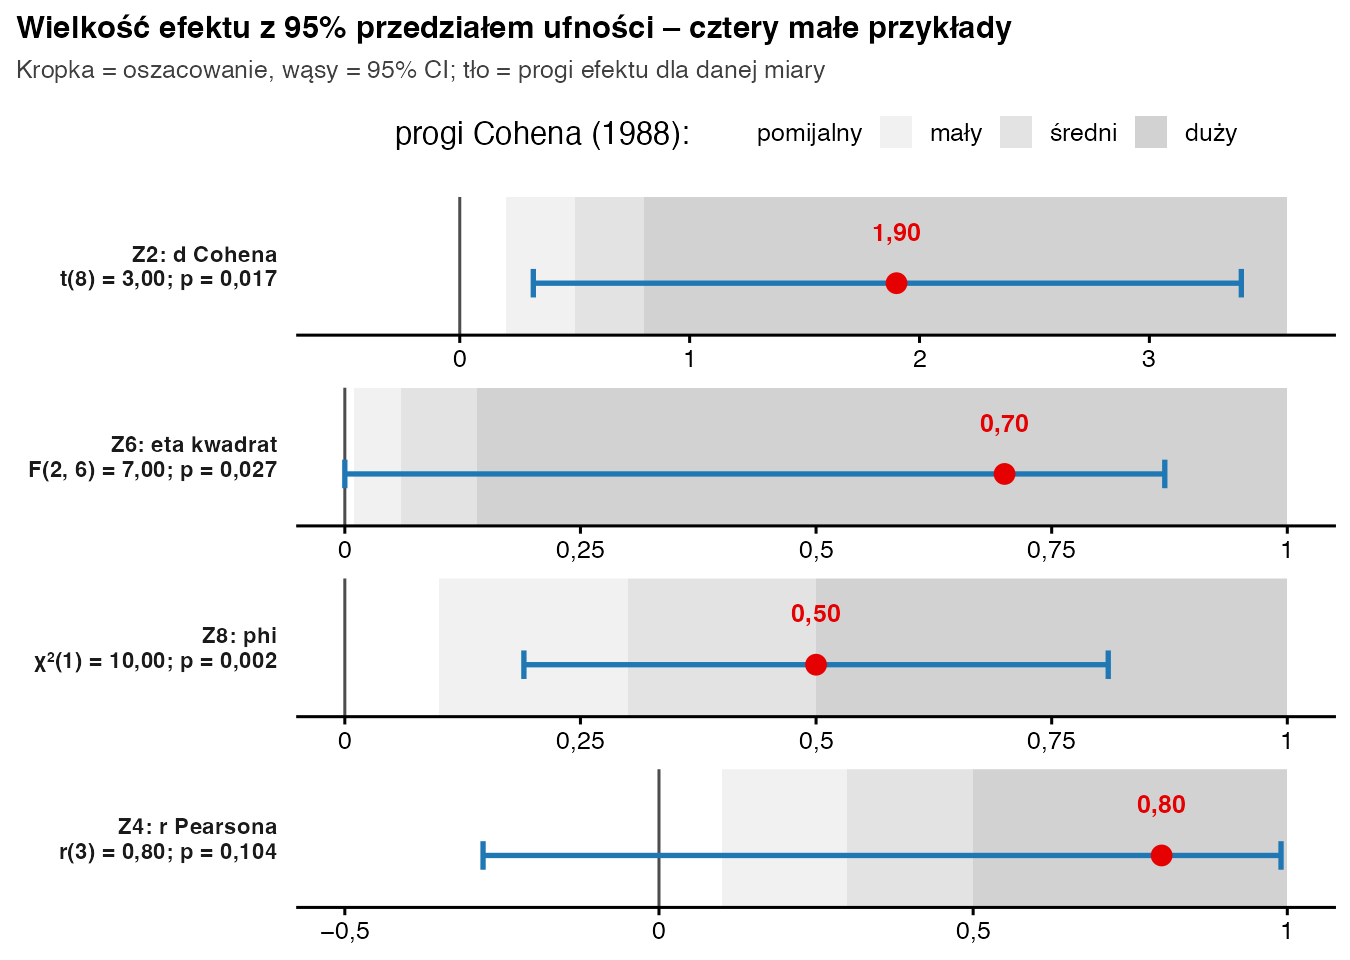
| Z2: notatki vs quizy (5 + 5 osób) | t(8) = 3,00; p = 0,017 | d = 1,90 [0,32; 3,40]; g = 1,71 | efekt duży, ale oszacowany bardzo niedokładnie |
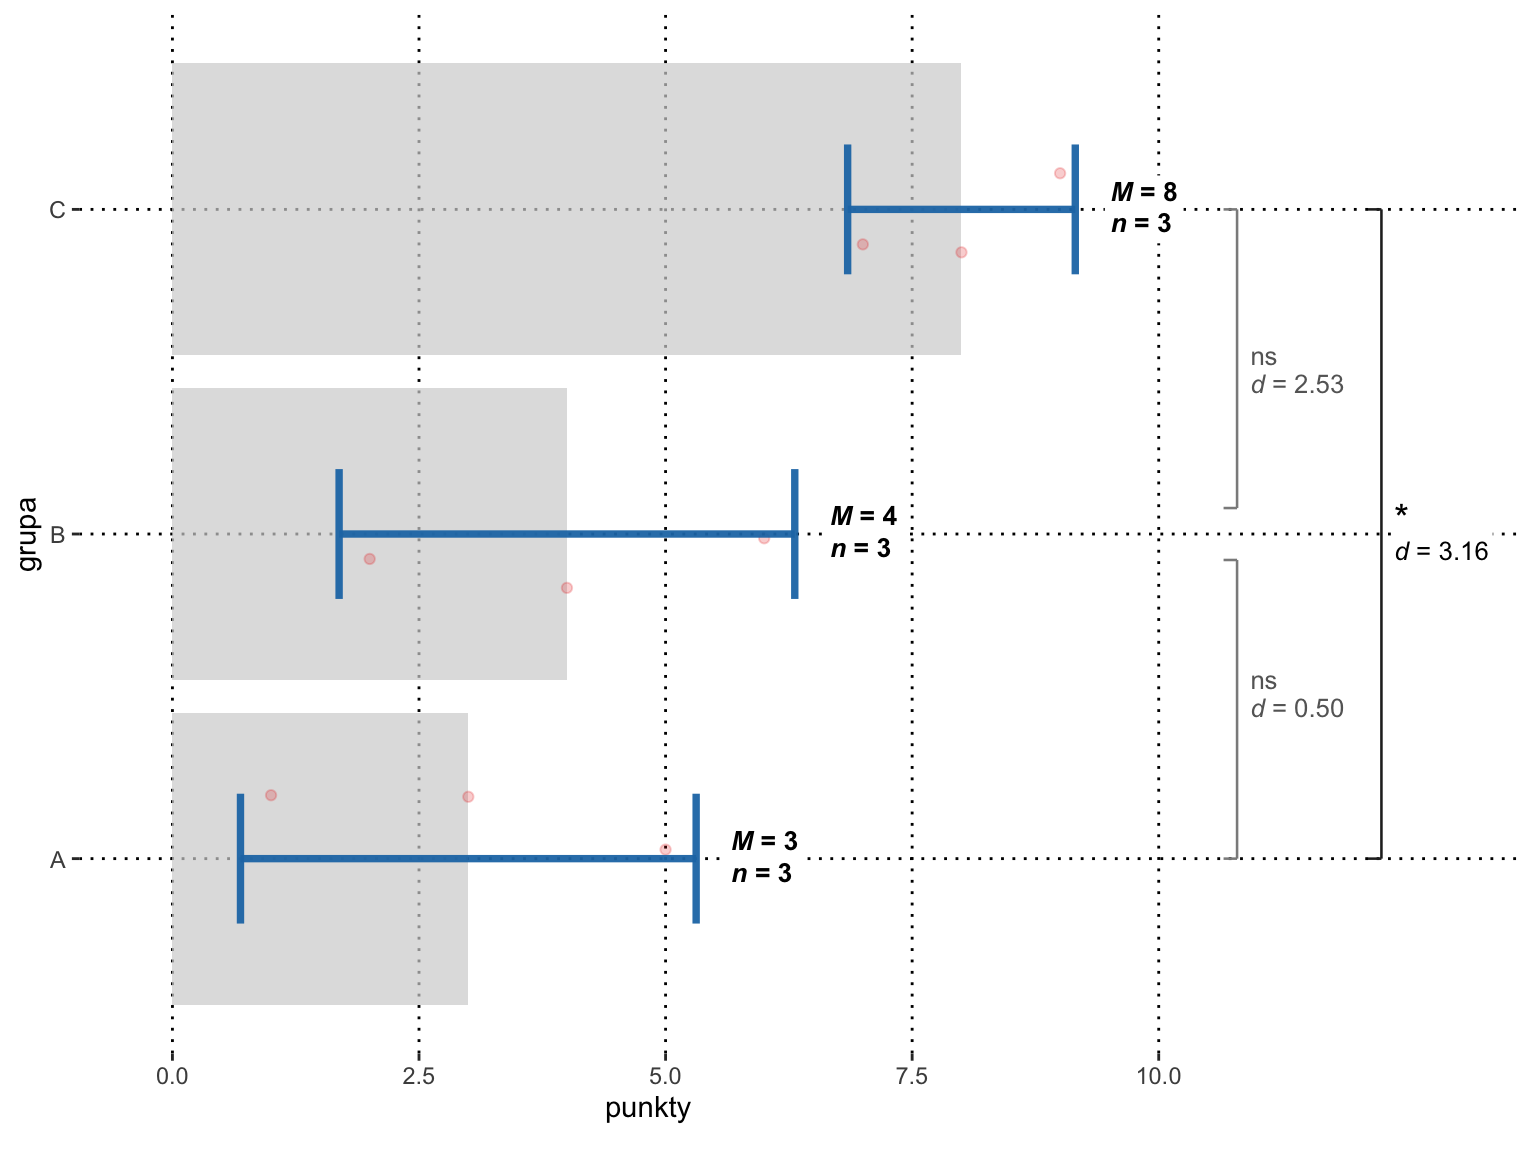
| Z6: trzy grupy ćwiczeniowe (3 × 3 osoby) | F(2, 6) = 7,00; p = 0,027 | η² = 0,70 [0,00; 0,87]; ω² = 0,57 | grupa wyjaśnia 70% zmienności punktów; przedział sięga zera |
| Z8: tabela 2×2 (N = 40) | χ²(1) = 10,00; p = 0,002 | φ = 0,50 [0,19; 0,81]; OR = 9,00 [2,15; 37,66] | związek silny; szansa 9 razy większa |
| Z4: godziny nauki i punkty (5 osób) | r(3) = 0,80; p = 0,104 | r = 0,80 [−0,28; 0,99]; R² = 0,64 | związek silny, ale nieistotny – za mało osób |
Przykład Z4 dobrze pokazuje, czego nie wolno pisać. Korelacja 0,80 to według progów efekt duży, a mimo to p = 0,104. Nie znaczy to, że związku nie ma. Przy pięciu osobach przedział ufności obejmuje i zero, i prawie idealny związek, więc dane nie pozwalają rozstrzygnąć. Uczciwy opis brzmi: „brak podstaw do odrzucenia H0; oszacowanie siły związku jest bardzo niepewne”. Z kolei η² = 0,70 w Z6 nie oznacza, że grupa „powoduje” 70% różnic – to opis podziału zmienności, a nie dowód przyczyny.
Przedziały ufności dla wielkości efektu w R
Pakiet effectsize (Ben-Shachar i in., 2020) liczy miary efektu razem z 95% przedziałem ufności. Dla η², ω², φ i V domyślnie podaje przedział jednostronny (z górną granicą 1), bo te miary nie mogą być ujemne. Do pracy zwykle lepszy jest przedział dwustronny – ustawisz go argumentem alternative = "two.sided". Kod liczy wszystkie liczby z Tabeli 2 oraz p z Rys. 1.
suppressPackageStartupMessages(library(effectsize))
ci <- function(x) { x <- as.data.frame(x)                # efekt i 95% CI w jednej linii
  round(unlist(x[1, setdiff(names(x)[sapply(x, is.numeric)], "CI")]), 2) }
# Z2: Notatki vs Quizy (test t) -> d Cohena i g Hedgesa
notatki <- c(1, 2, 3, 4, 5); quizy <- c(4, 5, 6, 7, 8)
round(t.test(quizy, notatki, var.equal = TRUE)$p.value, 3)
ci(cohens_d(quizy, notatki)); ci(hedges_g(quizy, notatki))
# Z6: trzy grupy ćwiczeniowe (ANOVA) -> eta i omega kwadrat
z6 <- data.frame(grupa = rep(c("A", "B", "C"), each = 3), punkty = c(1, 3, 5, 2, 4, 6, 7, 8, 9))
m6 <- aov(punkty ~ grupa, data = z6)
ci(eta_squared(m6, partial = FALSE, alternative = "two.sided"))
ci(omega_squared(m6, partial = FALSE, alternative = "two.sided"))
# Z8: tabela 2×2 (chi-kwadrat) -> phi i iloraz szans
tab <- matrix(c(15, 5, 5, 15), nrow = 2)
ci(phi(tab, adjust = FALSE, alternative = "two.sided"))
ci(oddsratio(tab))
# Z4: godziny nauki i punkty (korelacja) -> r i R²
x <- 1:5; y <- c(4, 2, 8, 6, 10)
k <- cor.test(x, y)
round(c(r = unname(k$estimate), CI = k$conf.int, p = k$p.value, R2 = unname(k$estimate^2)), 3)
# Ten sam efekt d = 0,5, różna liczba osób w grupie -> różne p
n <- c(10, 50, 200)
round(setNames(2 * pt(-0.5 * sqrt(n / 2), df = 2 * n - 2), n), 4)
Wynik w konsoli R:
[1] 0.017
Cohens_d   CI_low  CI_high
    1.90     0.32     3.40
Hedges_g   CI_low  CI_high
    1.71     0.29     3.07
   Eta2  CI_low CI_high
   0.70    0.00    0.87
 Omega2  CI_low CI_high
   0.57    0.00    0.82
    phi  CI_low CI_high
   0.50    0.19    0.81
Odds_ratio     CI_low    CI_high
      9.00       2.15      37.66
     r    CI1    CI2      p     R2
 0.800 -0.280  0.986  0.104  0.640
    10     50    200
0.2783 0.0141 0.0000
R zapisuje liczby z kropką, a p = 0,0000 oznacza tylko zaokrąglenie – w pracy napisz p < 0,001.
Jak raportować wielkość efektu – gotowe zdania
Test t: Studenci uczący się z quizów uzyskali więcej punktów niż studenci uczący się z notatek, t(8) = 3,00; p = 0,017; d = 1,90; 95% CI [0,32; 3,40]. Efekt był duży, choć przy pięciu osobach w grupie jego wielkość oszacowano mało precyzyjnie.
Wynik nieistotny: Związek liczby godzin nauki z liczbą punktów nie był istotny statystycznie, r(3) = 0,80; 95% CI [−0,28; 0,99]; p = 0,104. Brak podstaw do odrzucenia hipotezy zerowej, a szeroki przedział ufności wskazuje, że próba była za mała, by ocenić siłę związku.
Więcej wzorów zdań, także dla ANOVA i chi-kwadrat, zebraliśmy we wpisie opis wyników w stylu APA 7.
Najczęstsze błędy
- Wnioskowanie o sile efektu z p: „p < 0,001, więc efekt jest bardzo silny”.
- Brak informacji, którą miarę podajesz: η² czy cząstkowe η², r czy korelacja rangowo-dwuseryjna.
- Pomijanie efektu przy wyniku nieistotnym – właśnie wtedy pokazuje, czy próba była za mała.
- Traktowanie progów Cohena jak sztywnej reguły bez odniesienia do literatury.
- Pisanie, że zmienna „wpływa” albo „powoduje”, gdy badanie było korelacyjne.
Jaka wielkość efektu jest „dobra”?
Nie ma jednej odpowiedzi. Progi Cohena miały być punktem wyjścia, gdy nie wiadomo nic więcej (Cohen, 1988). Mały efekt w badaniu zdrowia publicznego może mieć duże znaczenie praktyczne, a duży efekt w pięcioosobowej próbie bywa przypadkiem. Porównaj swój wynik z metaanalizami i badaniami z Twojej dziedziny, a przy planowaniu badania użyj tej wartości do analizy mocy (Lakens, 2013).
Czy podawać wielkość efektu, gdy wynik jest nieistotny?
Tak. Wielkość efektu z przedziałem ufności mówi czytelnikowi, czy różnica była bliska zera, czy raczej duża, ale niepewna z powodu małej próby. Bez tej informacji wynik nieistotny łatwo błędnie odczytać jako „brak efektu”.
Bibliografia
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). https://doi.org/10.1037/0000165-000
- Ben-Shachar, M. S., Lüdecke, D., & Makowski, D. (2020). effectsize: Estimation of effect size indices and standardized parameters. Journal of Open Source Software, 5(56), 2815. https://doi.org/10.21105/joss.02815
- Chen, H., Cohen, P., & Chen, S. (2010). How big is a big odds ratio? Interpreting the magnitudes of odds ratios in epidemiological studies. Communications in Statistics – Simulation and Computation, 39(4), 860–864.
- Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates.
- Lakens, D. (2013). Calculating and reporting effect sizes to facilitate cumulative science: A practical primer for t-tests and ANOVAs. Frontiers in Psychology, 4, 863. https://doi.org/10.3389/fpsyg.2013.00863
- Wasserstein, R. L., & Lazar, N. A. (2016). The ASA statement on p-values: Context, process, and purpose. The American Statistician, 70(2), 129–133. https://doi.org/10.1080/00031305.2016.1154108
- Hryniewicz, K., & Milewska, A. (2023). SZTOS: System Zautomatyzowanego Tworzenia Opisu Statystycznego [Oprogramowanie]. SZTOS IT. https://sztos-it.com/
Zobacz też
- Słownik wzorówd Cohena – wielkość efektu
- Słownik wzorówCząstkowe η² i ω²
- Słownik wzorówWielkość efektu r w testach nieparametrycznych
- Słownik wzorówIloraz szans i ryzyko względne
- PoradnikAnaliza statystyczna – co to jest
- Przykładowy raportTest t Studenta
Potrzebujesz pomocy z analizą do pracy dyplomowej?
Policzymy Twoje wyniki, przygotujemy tabele, wykresy i opis w standardzie APA, który wykorzystasz w swojej pracy. Pomagamy jak statystyk i redaktor – autorem pracy zostajesz Ty. Konsultacja i wycena są bezpłatne.