

Mediacja z bootstrapem – jak opisać wyniki w artykule i pracy
Ten wpis pokazuje, jak policzyć model mediacji prostej z bootstrapowym przedziałem ufności i jak opisać go tak, żeby recenzent nie miał zastrzeżeń: ścieżki a, b, c′, efekt pośredni a·b, zapis APA, tabela i schemat. Przykład: czy związek łatwości korzystania z autonomicznego samochodu z intencją jego zakupu da się opisać jako przechodzący przez ocenę użyteczności?
W skrócieEfekt pośredni to iloczyn ścieżek a i b. O jego istotności rozstrzyga 95% przedział bootstrapowy: jeśli nie obejmuje zera, efekt pośredni jest istotny. W opisie podaj współczynniki niestandaryzowane z przedziałami, β, liczbę prób, typ przedziału i ziarno. Przy danych z jednego pomiaru pisz o związkach i efekcie pośrednim w modelu, a nie o wpływie. Obliczenia na małych danych pokazujemy w haśle efekt pośredni i test Sobela oraz we wpisie analiza mediacji – przykład.
Krok 1. Model, hipoteza i dane
Korzystamy ze zbioru demonstracyjnego CRUIZE: 303 osoby oceniły autonomiczny samochód w ankiecie. Każda zmienna to średnia z czterech pozycji skali od 1 do 5. Zmienna X to łatwość korzystania, M to postrzegana użyteczność, a Y to intencja zakupu. Hipoteza dotyczy efektu pośredniego: H0 mówi, że a·b = 0. Kolejność X → M → Y wynika z teorii (model akceptacji technologii; Davis, 1989), a nie z danych.
| Zmienna | M | SD | 1 | 2 |
|---|---|---|---|---|
| 1. Łatwość korzystania (X) | 3,61 | 0,79 | – | |
| 2. Użyteczność (M) | 3,24 | 0,89 | 0,48 | – |
| 3. Intencja zakupu (Y) | 2,76 | 1,03 | 0,35 | 0,72 |
Wszystkie korelacje są dodatnie. Warunek mediacji z dawnej procedury Barona i Kenny’ego (istotny związek X z Y) nie jest dziś wymagany, ale warto go pokazać w tabeli opisowej.
Krok 2. Ścieżki i efekty
Każda ścieżka to współczynnik regresji liniowej. Model liczymy w pakiecie lavaan jednym poleceniem, a przedziały ufności dają 5000 prób bootstrapowych.
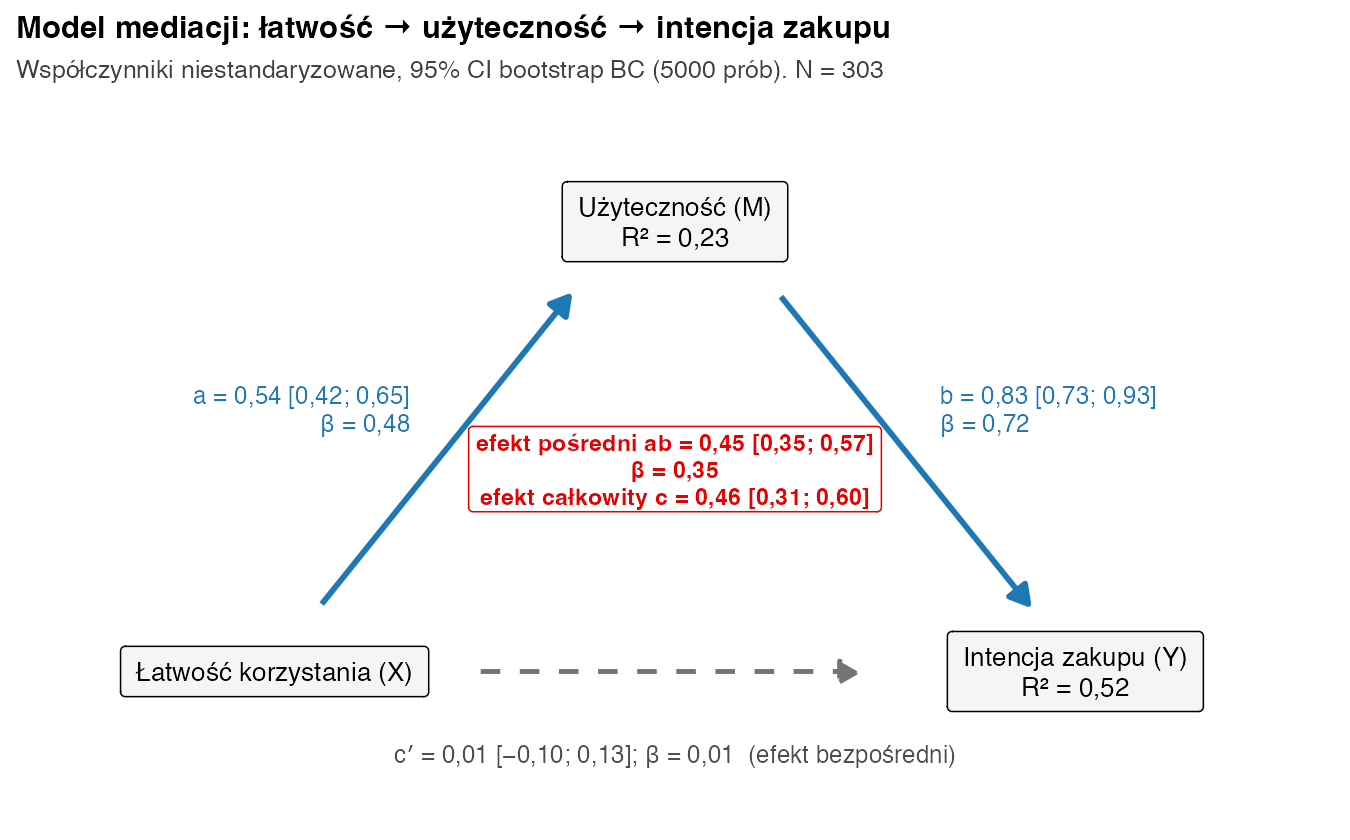
- Ścieżka a (X → M): a = 0,54; 95% CI [0,42; 0,65]. Osoby, które oceniają obsługę o punkt łatwiej, oceniają użyteczność średnio o 0,54 punktu wyżej.
- Ścieżka b (M → Y przy stałym X): b = 0,83; 95% CI [0,73; 0,93].
- Efekt bezpośredni c′ (X → Y przy stałym M): c′ = 0,01; 95% CI [−0,10; 0,13]. Przedział obejmuje zero.
- Efekt pośredni: a·b = 0,54 × 0,83 = 0,45; 95% CI [0,35; 0,57]. Przedział nie obejmuje zera, więc efekt pośredni jest istotny statystycznie.
- Efekt całkowity: c = c′ + a·b = 0,01 + 0,45 = 0,46; 95% CI [0,31; 0,60]. Efekt pośredni stanowi 98% efektu całkowitego.
Krok 3. Bootstrap: co to za przedział?
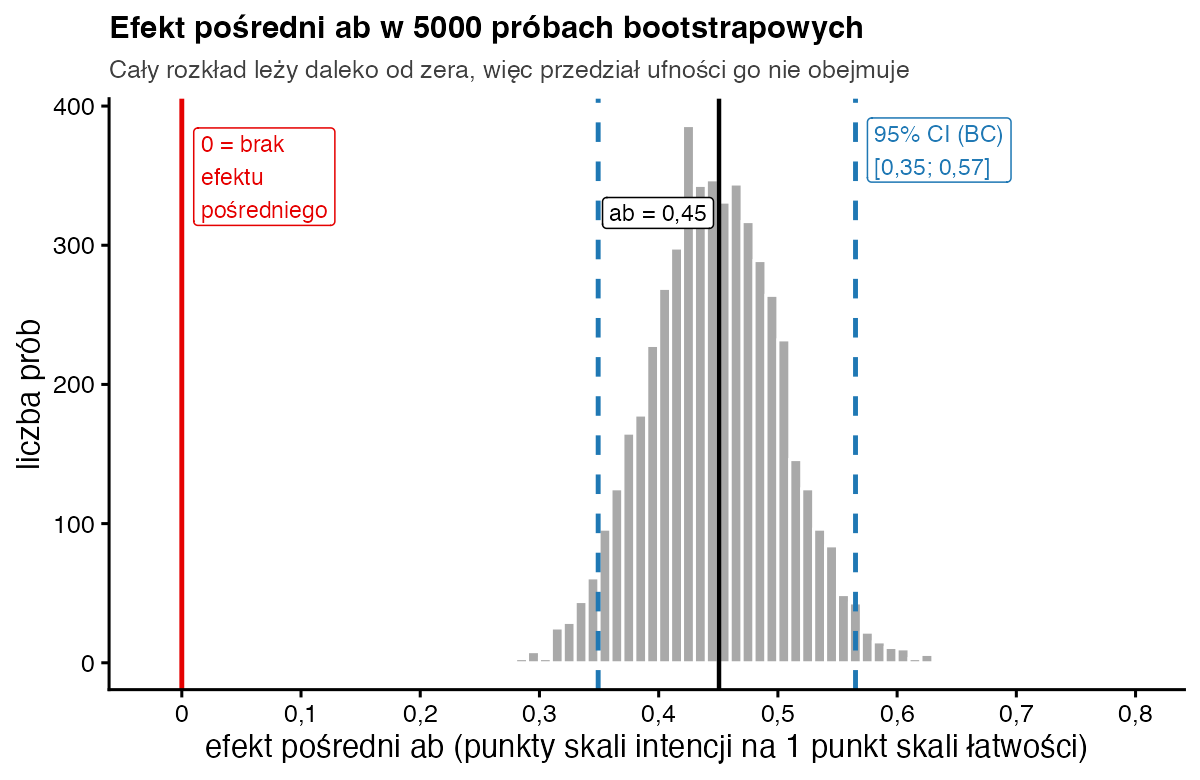
Bootstrap losuje ze zwracaniem 303 osoby, liczy w tej próbie a·b i powtarza to 5000 razy. Z rozkładu wyników bierzemy granice przedziału. Przedział percentylowy to po prostu 2,5. i 97,5. centyl: [0,34; 0,56]. Przedział BC (z korektą obciążenia) przesuwa te centyle, gdy rozkład jest niesymetryczny: [0,35; 0,57]. Przy dużej próbie oba prowadzą do tego samego wniosku. W małych próbach BC bywa zbyt liberalny, czyli częściej daje fałszywie istotny wynik (Fritz i in., 2012), więc wtedy wybierz przedział percentylowy. Test Sobela zakłada normalny rozkład a·b i ma mniejszą moc (MacKinnon i in., 2004), dlatego podawaj go najwyżej jako uzupełnienie.
Krok 4. Zapis wyników i tabela
Zapis w stylu APA: Model mediacji prostej oszacowano w pakiecie lavaan metodą największej wiarygodności (N = 303). Przedziały ufności wyznaczono metodą bootstrap z korektą obciążenia (BC; 5000 prób, ziarno 2026). Wyższa ocena łatwości korzystania wiązała się z wyższą oceną użyteczności, a = 0,54; 95% CI [0,42; 0,65]; β = 0,48. Wyższa ocena użyteczności wiązała się z wyższą intencją zakupu przy kontroli łatwości, b = 0,83; 95% CI [0,73; 0,93]; β = 0,72. Efekt pośredni był istotny, ab = 0,45; 95% CI [0,35; 0,57]; β = 0,35. Efekt bezpośredni okazał się nieistotny, c′ = 0,01; 95% CI [−0,10; 0,13]. Efekt całkowity wyniósł c = 0,46; 95% CI [0,31; 0,60]. Model wyjaśniał 23% wariancji użyteczności i 52% wariancji intencji zakupu.
| Efekt | b | SE | 95% CI (BC) | β |
|---|---|---|---|---|
| a: łatwość → użyteczność | 0,54 | 0,06 | [0,42; 0,65] | 0,48 |
| b: użyteczność → intencja | 0,83 | 0,05 | [0,73; 0,93] | 0,72 |
| c′: łatwość → intencja (bezpośredni) | 0,01 | 0,06 | [−0,10; 0,13] | 0,01 |
| ab: efekt pośredni | 0,45 | 0,05 | [0,35; 0,57] | 0,35 |
| c: efekt całkowity | 0,46 | 0,07 | [0,31; 0,60] | 0,35 |
W nocie podaj: liczbę prób bootstrapowych, typ przedziału, ziarno i to, że SE pochodzą z bootstrapu. Współczynniki standaryzowane β wyjaśnia hasło standaryzowany współczynnik β, a R² – hasło współczynnik determinacji.
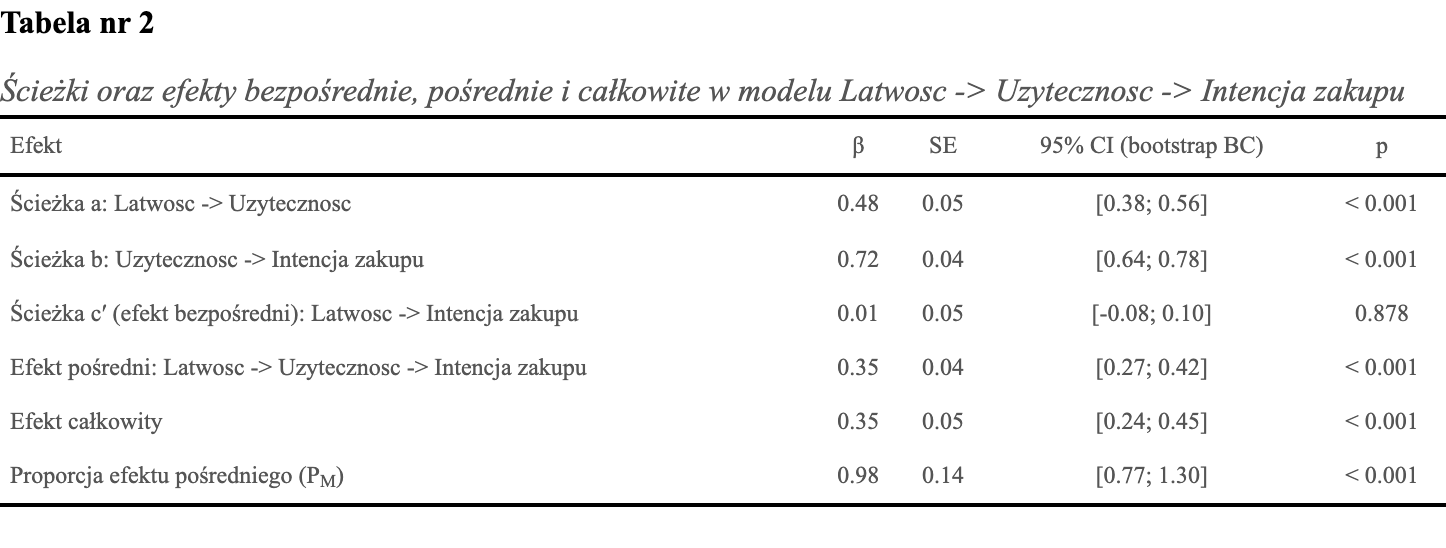
Automatyczne raporty, także z SZTOS, używają słowa „wpływał”. Przy danych przekrojowych zamień je w tekście pracy na „wiązał się”.
Cała analiza w R
library(readxl); library(lavaan)
# zbiór demonstracyjny CRUIZE (N = 303), ankieta o autonomicznym samochodzie;
# każda zmienna to średnia z 4 pozycji skali 1–5
d <- read_excel("Dane_CRUIZE_elegant.xlsx")
d <- data.frame(X = d$Łatwość, M = d$Użyteczność, Y = d$Intencja_zakupu)

# 1) statystyki opisowe i korelacje
round(sapply(d, function(v) c(M = mean(v), SD = sd(v))), 2)
round(cor(d), 2)

# 2) model mediacji: ścieżki a, b, c′ oraz efekty ab i c
model <- '
  M ~ a * X
  Y ~ cp * X + b * M
  ab := a * b          # efekt pośredni
  c  := cp + a * b     # efekt całkowity
'
fit <- sem(model, data = d, se = "bootstrap", bootstrap = 5000, iseed = 2026)

# 3) współczynniki niestandaryzowane, 95% CI bootstrap BC
pe <- parameterEstimates(fit, boot.ci.type = "bca.simple")
pe[pe$label != "", c("label", "est", "se", "ci.lower", "ci.upper")]

# 4) współczynniki standaryzowane (β) z przedziałami bootstrap BC
st <- standardizedSolution(fit, boot_ci_type = "bca.simple")
st[st$label != "", c("label", "est.std", "ci.lower", "ci.upper")]
round(inspect(fit, "r2"), 2)
Wynik w konsoli R:
      X    M    Y
M  3.61 3.24 2.76
SD 0.79 0.89 1.03
     X    M    Y
X 1.00 0.48 0.35
M 0.48 1.00 0.72
Y 0.35 0.72 1.00
  label   est    se ci.lower ci.upper
1     a 0.543 0.060    0.419    0.652
2    cp 0.010 0.059   -0.102    0.130
3     b 0.830 0.051    0.731    0.930
7    ab 0.451 0.055    0.349    0.565
8     c 0.460 0.075    0.307    0.603
  label est.std ci.lower ci.upper
1     a   0.482    0.379    0.568
2    cp   0.007   -0.080    0.100
3     b   0.717    0.644    0.785
7    ab   0.345    0.271    0.421
8     c   0.353    0.237    0.454
   M    Y
0.23 0.52
Dane z jednego pomiaru: związek, nie wpływ
Mediacja liczona na danych przekrojowych pokazuje, że układ korelacji pasuje do modelu X → M → Y. Nie dowodzi, że łatwość „powoduje” intencję zakupu. Te same dane pasują do innych kierunków, a oszacowania efektu pośredniego z jednego pomiaru bywają mocno obciążone (Maxwell i Cole, 2007). Do tego wszystkie trzy skale pochodzą z jednej ankiety, co może zawyżać korelacje – zobacz wpis o common method bias. W dyskusji napisz to wprost i zaproponuj badanie podłużne lub eksperyment.
Checklista przed wysłaniem tekstu
- Kierunek modelu uzasadniony teorią w części wstępnej.
- Efekt pośredni z przedziałem bootstrapowym; podana liczba prób, typ przedziału i ziarno.
- Współczynniki niestandaryzowane z CI oraz β; R² dla M i Y.
- Schemat ścieżek z czytelnymi etykietami i tabela efektów.
- Brak słów „wpływa” i „powoduje” przy danych z jednego pomiaru.
- Opis metody w sekcji analizy – wzór znajdziesz we wpisie sekcja „Analiza statystyczna” w artykule.
Pytania recenzentów
Czy to mediacja pełna?
Lepiej nie używać tej etykiety. Nieistotne c′ zależy głównie od liczebności próby (Rucker i in., 2011). Napisz, że efekt bezpośredni był nieistotny, a efekt pośredni stanowił 98% efektu całkowitego. Według typologii Zhao i in. (2010) to mediacja wyłącznie pośrednia.
Ile osób potrzeba do mediacji?
Przy średnich ścieżkach a i b bootstrap potrzebuje około 70–80 osób, by z mocą 0,80 wykryć efekt pośredni, a przy słabych – kilkuset (Fritz i MacKinnon, 2007). Jak zaplanować liczebność do wniosku, pokazujemy we wpisie analiza mocy do grantu.
Podawać b czy β?
Najlepiej oba. Współczynnik niestandaryzowany b ma jednostki skali (tu: punkty na skali 1–5) i to dla niego liczysz bootstrapowy przedział. β pozwala porównać siłę ścieżek między badaniami i zmiennymi o różnych skalach. Jeśli czasopismo ma limit miejsca, w tekście zostaw b z przedziałem, a β przenieś do tabeli.
Czym to się różni od moderacji?
Mediacja pyta, przez co X wiąże się z Y. Moderacja pyta, kiedy lub dla kogo ten związek jest silniejszy – zobacz moderacja i proste nachylenia.
Bibliografia
- Preacher, K. J., & Hayes, A. F. (2008). Asymptotic and resampling strategies for assessing and comparing indirect effects in multiple mediator models. Behavior Research Methods, 40(3), 879–891. https://doi.org/10.3758/BRM.40.3.879
- MacKinnon, D. P., Lockwood, C. M., & Williams, J. (2004). Confidence limits for the indirect effect: Distribution of the product and resampling methods. Multivariate Behavioral Research, 39(1), 99–128. https://doi.org/10.1207/s15327906mbr3901_4
- Fritz, M. S., Taylor, A. B., & MacKinnon, D. P. (2012). Explanation of two anomalous results in statistical mediation analysis. Multivariate Behavioral Research, 47(1), 61–87. https://doi.org/10.1080/00273171.2012.640596
- Davis, F. D. (1989). Perceived usefulness, perceived ease of use, and user acceptance of information technology. MIS Quarterly, 13(3), 319–340. https://doi.org/10.2307/249008
- Fritz, M. S., & MacKinnon, D. P. (2007). Required sample size to detect the mediated effect. Psychological Science, 18(3), 233–239. https://doi.org/10.1111/j.1467-9280.2007.01882.x
- Hayes, A. F. (2022). Introduction to mediation, moderation, and conditional process analysis: A regression-based approach (3rd ed.). Guilford Press.
- Maxwell, S. E., & Cole, D. A. (2007). Bias in cross-sectional analyses of longitudinal mediation. Psychological Methods, 12(1), 23–44. https://doi.org/10.1037/1082-989X.12.1.23
- Rucker, D. D., Preacher, K. J., Tormala, Z. L., & Petty, R. E. (2011). Mediation analysis in social psychology: Current practices and new recommendations. Social and Personality Psychology Compass, 5(6), 359–371. https://doi.org/10.1111/j.1751-9004.2011.00355.x
- Zhao, X., Lynch, J. G., Jr., & Chen, Q. (2010). Reconsidering Baron and Kenny: Myths and truths about mediation analysis. Journal of Consumer Research, 37(2), 197–206. https://doi.org/10.1086/651257
- Rosseel, Y. (2012). lavaan: An R package for structural equation modeling. Journal of Statistical Software, 48(2), 1–36. https://doi.org/10.18637/jss.v048.i02
- Hryniewicz, K., & Milewska, A. (2023). SZTOS: System Zautomatyzowanego Tworzenia Opisu Statystycznego [Oprogramowanie]. SZTOS IT. https://sztos-it.com/
Zobacz też
- Słownik wzorówEfekt pośredni i test Sobela
- Słownik wzorówBootstrap
- PoradnikAnaliza mediacji – przykład
- Przykładowy raportPrzykładowy raport SZTOS: analiza mediacji
- PoradnikSekcja „Analiza statystyczna” w artykule – jak napisać
Przygotowujesz artykuł, doktorat lub grant?
Zaplanujemy i wykonamy analizy, przygotujemy raport z tabelami, wykresami i kodem R oraz pomożemy odpowiedzieć na uwagi recenzentów dotyczące statystyki.