

Moderacja i proste nachylenia – przykład krok po kroku w R
Moderacja odpowiada na pytanie „kiedy?” albo „u kogo?” związek X z Y jest silniejszy lub słabszy. Pokazujemy cały przebieg: centrowanie, model z interakcją, przyrost R², proste nachylenia przy M ± 1 SD, region Johnsona-Neymana, wykres i zapis w stylu APA. Pytanie badawcze: czy wsparcie społeczne osłabia związek stresu w pracy z wypaleniem?
W skrócieCentrujesz predyktor i moderator → dodajesz iloczyn do modelu → sprawdzasz b3 i ΔR² → jeśli interakcja jest istotna, „sondujesz” ją prostymi nachyleniami i regionem Johnsona-Neymana → opisujesz efekty warunkowe, a nie „efekty główne”. Wzór na proste nachylenie i jego błąd standardowy z rachunkiem na kartce znajdziesz w haśle interakcja w regresji – wzór i przykład.
Moderacja – co to jest i czym różni się od mediacji?
Moderator (M) to zmienna, od której zależy siła lub kierunek związku predyktora (X) ze zmienną zależną (Y). W modelu regresji zapisujesz to iloczynem: ŷ = b0 + b1X + b2M + b3XM. Współczynnik b3 mówi, o ile zmienia się nachylenie X, gdy M rośnie o 1. Mediacja pyta o coś innego – „przez co?” X wiąże się z Y. Jeśli to Twój przypadek, zajrzyj do wpisu mediacja z bootstrapem – jak opisać wyniki. Gdy oba czynniki są grupami, ten sam pomysł nazywa się interakcją w dwuczynnikowej ANOVA.
Krok 1. Dane, hipoteza i centrowanie
Mamy 12 pracowników: stres w pracy (1–7), wsparcie społeczne (1–7) i wynik w skali wypalenia (punkty). Obie skale 1–7 mają średnią 4 i SD = 2, a wypalenie M = 12,00; SD = 4,24. Stres koreluje z wypaleniem dodatnio (r = 0,69), wsparcie ujemnie (r = −0,50), a stres i wsparcie nie są ze sobą skorelowane (r = 0,00). To mały zbiór do nauki – w artykule potrzebujesz znacznie więcej osób (patrz FAQ).
| Osoba | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | 9 | 10 | 11 | 12 |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| stres | 2 | 6 | 2 | 6 | 3 | 4 | 7 | 1 | 5 | 6 | 4 | 2 |
| wsparcie | 1 | 2 | 2 | 2 | 3 | 4 | 4 | 5 | 6 | 6 | 6 | 7 |
| wypalenie | 10 | 19 | 10 | 18 | 13 | 13 | 18 | 6 | 9 | 9 | 9 | 10 |
- H1 (moderacja): im wyższe wsparcie, tym słabszy dodatni związek stresu z wypaleniem (b3 < 0). H0: b3 = 0, czyli nachylenie stresu nie zależy od wsparcia; α = 0,05.
- Centrowanie: od każdego wyniku odejmujesz średnią (stres − 4, wsparcie − 4). Dzięki temu zero oznacza „przeciętną osobę”, a nie wartość spoza skali.
Krok 2. Model z interakcją i przyrost R²
| Predyktor | b | SE | 95% CI dla b | t(8) | p |
|---|---|---|---|---|---|
| stała | 12,00 | 0,43 | [11,00; 13,00] | 27,66 | < 0,001 |
| stres (X) | 1,38 | 0,23 | [0,86; 1,91] | 6,09 | < 0,001 |
| wsparcie (M) | −1,30 | 0,23 | [−1,84; −0,76] | −5,56 | 0,001 |
| stres × wsparcie | −0,51 | 0,13 | [−0,80; −0,22] | −4,03 | 0,004 |
| R² = 0,91; skorygowane R² = 0,87; F(3, 8) = 26,55; p < 0,001. Model bez iloczynu: R² = 0,72; ΔR² = 0,19; F(1, 8) = 16,22; p = 0,004; n = 12 | |||||
- Interakcja: b3 = −0,51. Każdy punkt wsparcia więcej zmniejsza nachylenie stresu średnio o 0,51 punktu wypalenia. Przedział ufności nie obejmuje zera.
- Przyrost R²: sam iloczyn wyjaśnia dodatkowe 19% zmienności wypalenia. Test F dla ΔR² to w modelu z jednym iloczynem ten sam test co t dla b3 (16,22 = 4,03²). Tak raportuje się regresję hierarchiczną – zobacz ΔR² w regresji hierarchicznej.
- b1 i b2 to efekty warunkowe: b1 = 1,38 to nachylenie stresu przy przeciętnym wsparciu, a b2 = −1,30 – nachylenie wsparcia przy przeciętnym stresie. Nie są to „efekty główne” w sensie ANOVA.
Krok 3. Proste nachylenia przy M − 1 SD, M i M + 1 SD
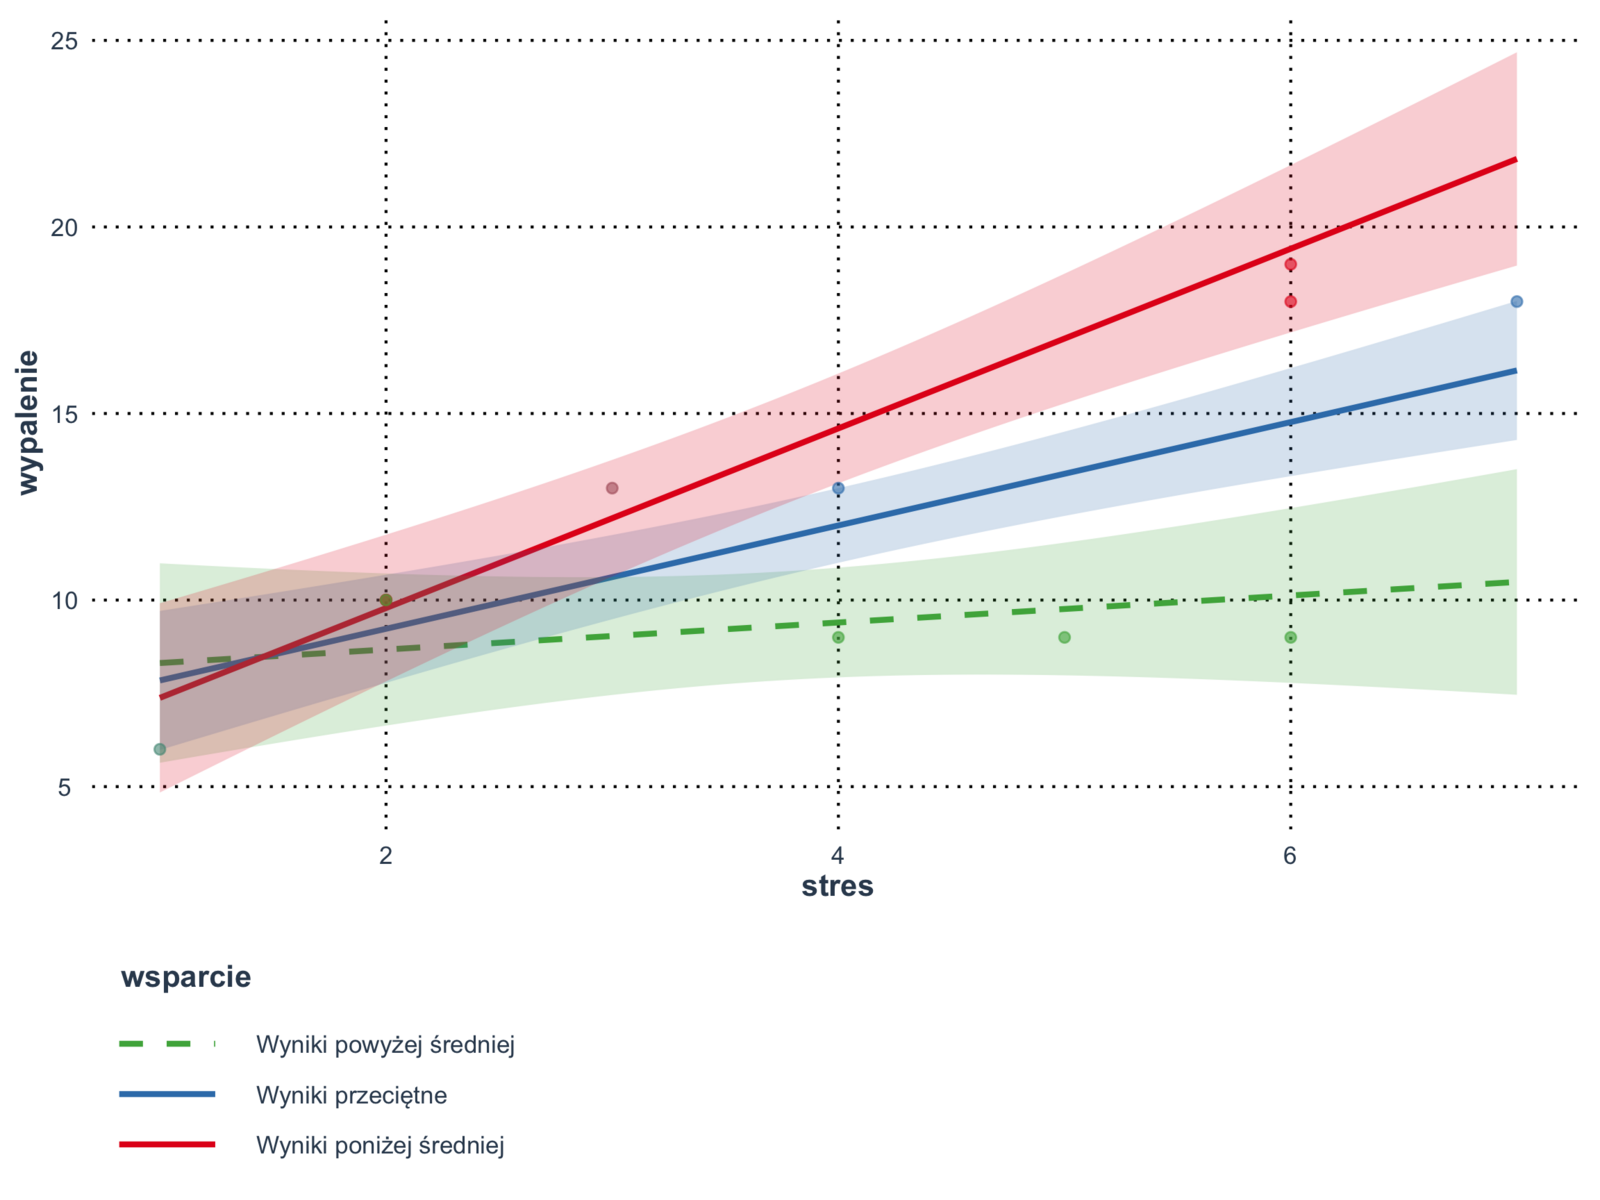
Istotna interakcja mówi tylko, że nachylenia się różnią. Żeby wiedzieć jak, liczysz proste nachylenia (ang. simple slopes) stresu przy trzech poziomach wsparcia: 2 (M − 1 SD), 4 (M) i 6 (M + 1 SD), zgodnie z propozycją Aiken i West (1991).
| Wsparcie | Nachylenie b | SE | 95% CI | t(8) | p |
|---|---|---|---|---|---|
| niskie: 2 (M − 1 SD) | 2,41 | 0,33 | [1,65; 3,16] | 7,35 | < 0,001 |
| przeciętne: 4 (M) | 1,38 | 0,23 | [0,86; 1,91] | 6,09 | < 0,001 |
| wysokie: 6 (M + 1 SD) | 0,36 | 0,35 | [−0,45; 1,18] | 1,02 | 0,336 |
Przy niskim wsparciu każdy punkt stresu więcej to średnio o 2,41 punktu wyższe wypalenie. Przy wysokim wsparciu nachylenie spada do 0,36 i jest nieistotne – brak podstaw do odrzucenia hipotezy, że wynosi zero. To nie dowód, że związku tam nie ma: przedział sięga od −0,45 do 1,18.
Krok 4. Region Johnsona-Neymana
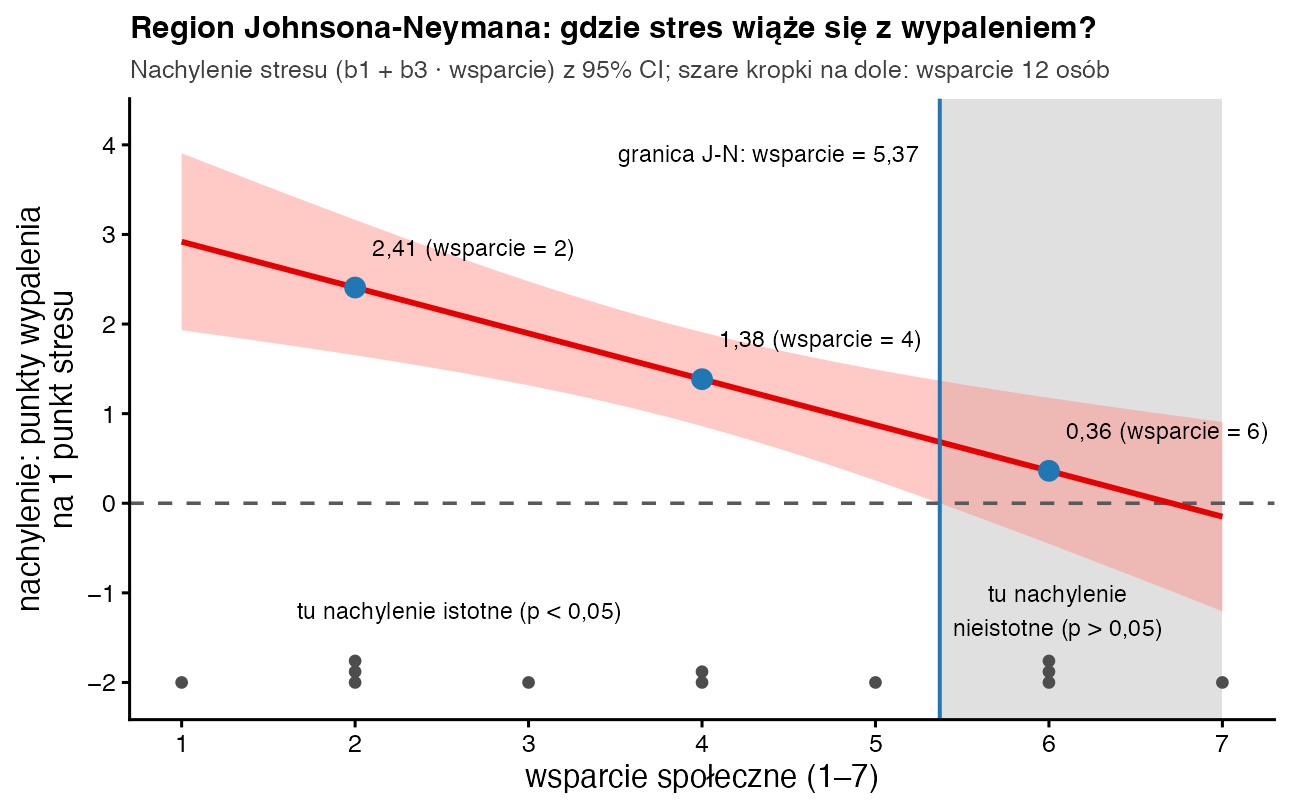
Wybór M ± 1 SD jest umowny. Metoda Johnsona-Neymana (Johnson i Neyman, 1936; Bauer i Curran, 2005) podaje dokładną wartość moderatora, przy której nachylenie przestaje być istotne. U nas granica wynosi 5,37: dla wsparcia poniżej 5,37 stres istotnie wiąże się z wypaleniem, a powyżej – nie. Druga granica (10,82) leży poza skalą 1–7, więc jej nie interpretujesz. Powyżej granicy są tylko 4 osoby z 12 (33%) – napisz to, bo wniosek o „wysokim wsparciu” opiera się na niewielu obserwacjach.
„Efekty główne” przy interakcji – najczęstszy błąd
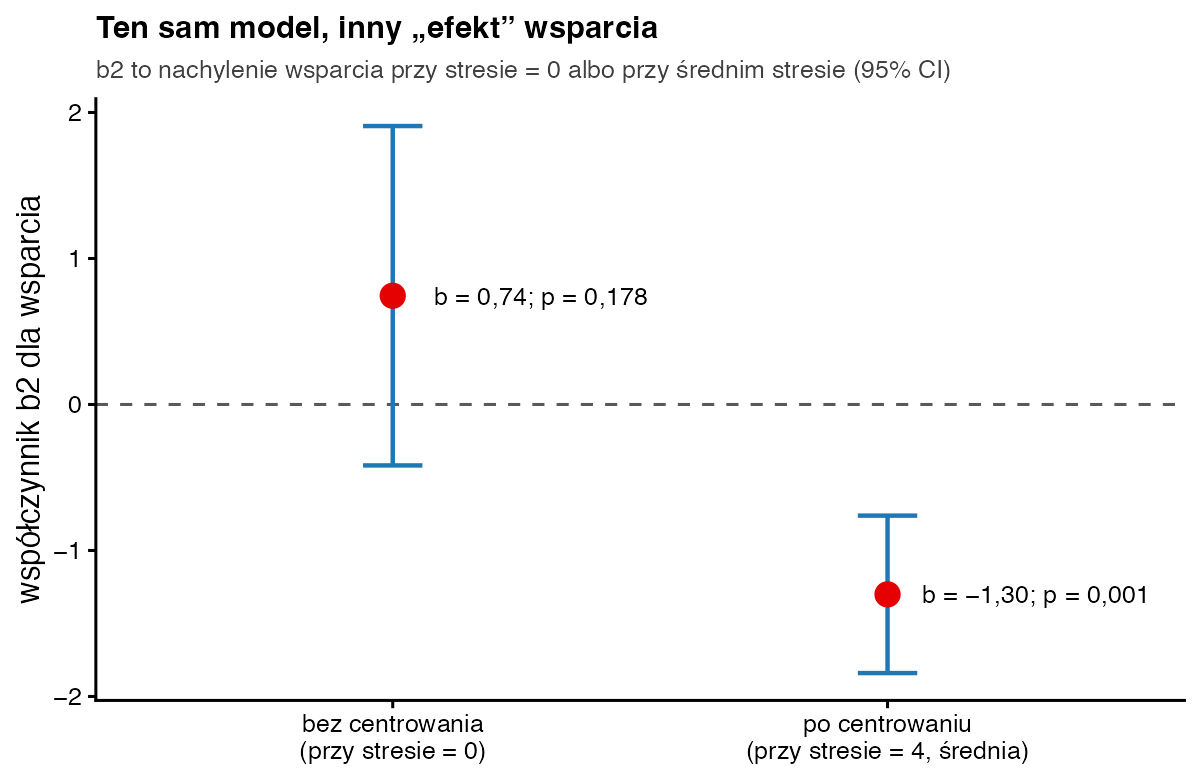
Bez centrowania R podaje dla wsparcia b = 0,74; p = 0,178. Kusi, by napisać „wsparcie nie wiąże się z wypaleniem”. To błąd: ten współczynnik opisuje nachylenie wsparcia przy stresie równym 0, a takiego wyniku na skali 1–7 nie ma. Po centrowaniu ten sam model daje b = −1,30; p = 0,001 – nachylenie przy przeciętnym stresie. Interakcja b3, R² i wykres są w obu wersjach identyczne. Centrowanie obniża też VIF iloczynu z 9,64 do 1,07, ale to tylko kosmetyka: zmienia się znaczenie b1 i b2, a nie jakość modelu (Echambadi i Hess, 2007).
Założenia modelu
Sprawdzasz je jak w zwykłej regresji, na resztach modelu z iloczynem (szczegóły we wpisie diagnostyka regresji na wykresach). Tutaj: Shapiro-Wilk dla reszt W = 0,95; p = 0,603; test stałości wariancji p = 0,955; największa odległość Cooka 0,78, czyli poniżej często stosowanego progu 1. Pamiętaj też, że moderacja zakłada liniową zmianę nachylenia wraz z M.
Jak opisać moderację w pracy (APA)?
Zapis w stylu APA: Aby sprawdzić, czy wsparcie społeczne moderuje związek stresu w pracy z wypaleniem, przeprowadzono regresję liniową z wycentrowanymi predyktorami i ich iloczynem. Model wyjaśniał 91% zmienności wypalenia, F(3, 8) = 26,55; p < 0,001. Interakcja stresu i wsparcia była istotna, b = −0,51; 95% CI [−0,80; −0,22]; t(8) = −4,03; p = 0,004; ΔR² = 0,19. Analiza prostych nachyleń wykazała, że przy niskim wsparciu (M − 1 SD) wyższy stres wiązał się z wyższym wypaleniem, b = 2,41; p < 0,001, podobnie przy przeciętnym wsparciu, b = 1,38; p < 0,001, natomiast przy wysokim wsparciu (M + 1 SD) związek był nieistotny, b = 0,36; 95% CI [−0,45; 1,18]; p = 0,336. Według metody Johnsona-Neymana związek stresu z wypaleniem był istotny dla wsparcia poniżej 5,37 (67% próby).
Więcej gotowych zdań i zasad zapisu znajdziesz w poradniku opis wyników w stylu APA 7. Wynik pokazuje związek warunkowy w danych przekrojowych – nie pisz, że wsparcie „chroni przed” wypaleniem, tylko że związek był słabszy przy wyższym wsparciu.
Cała analiza w R
# 12 pracowników: stres w pracy (1–7), wsparcie społeczne (1–7), wypalenie (punkty)
dane <- data.frame(stres     = c(2, 6, 2, 6, 3, 4, 7, 1, 5, 6, 4, 2),
                   wsparcie  = c(1, 2, 2, 2, 3, 4, 4, 5, 6, 6, 6, 7),
                   wypalenie = c(10, 19, 10, 18, 13, 13, 18, 6, 9, 9, 9, 10))

# 1) centrowanie: odejmujemy średnie (obie wynoszą 4, SD obu = 2)
dane$stres_c    <- dane$stres - mean(dane$stres)
dane$wsparcie_c <- dane$wsparcie - mean(dane$wsparcie)

# 2) model bez interakcji i z interakcją, przyrost R² (test F)
m0 <- lm(wypalenie ~ stres_c + wsparcie_c, data = dane)
m1 <- lm(wypalenie ~ stres_c * wsparcie_c, data = dane)
round(coef(summary(m1)), 3)
round(confint(m1), 2)
round(c(R2_bez = summary(m0)$r.squared, R2_z = summary(m1)$r.squared), 3)
anova(m0, m1)

# 3) proste nachylenia ręcznie: b1 + b3·w, SE z macierzy vcov (w = −1 SD, średnia, +1 SD)
b <- coef(m1); V <- vcov(m1); w <- c(-2, 0, 2)
nach <- b[2] + b[4] * w
se   <- sqrt(V[2, 2] + w^2 * V[4, 4] + 2 * w * V[2, 4])
round(cbind(w, nach, se, t = nach / se, p = 2 * pt(-abs(nach / se), df = 8)), 3)

# 4) to samo z pakietu interactions + region Johnsona-Neymana
library(interactions)
sim_slopes(m1, pred = stres_c, modx = wsparcie_c, modx.values = c(-2, 0, 2),
           johnson_neyman = TRUE, jnplot = FALSE)

# 5) dla porównania: model bez centrowania (b3 to samo, b1 i b2 znaczą co innego)
round(coef(summary(lm(wypalenie ~ stres * wsparcie, data = dane))), 3)
Wynik w konsoli R:
                   Estimate Std. Error t value Pr(>|t|)
(Intercept)          12.000      0.434  27.657    0.000
stres_c               1.385      0.227   6.094    0.000
wsparcie_c           -1.301      0.234  -5.562    0.001
stres_c:wsparcie_c   -0.511      0.127  -4.027    0.004
                   2.5 % 97.5 %
(Intercept)        11.00  13.00
stres_c             0.86   1.91
wsparcie_c         -1.84  -0.76
stres_c:wsparcie_c -0.80  -0.22
R2_bez   R2_z
 0.724  0.909
Analysis of Variance Table

Model 1: wypalenie ~ stres_c + wsparcie_c
Model 2: wypalenie ~ stres_c * wsparcie_c
  Res.Df    RSS Df Sum of Sq      F   Pr(>F)
1      9 54.705
2      8 18.073  1    36.632 16.215 0.003805 **
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
      w  nach    se     t     p
[1,] -2 2.408 0.328 7.348 0.000
[2,]  0 1.385 0.227 6.094 0.000
[3,]  2 0.362 0.353 1.024 0.336
JOHNSON-NEYMAN INTERVAL

When wsparcie_c is OUTSIDE the interval [1.37, 6.82], the slope of
stres_c is p < .05.

Note: The range of observed values of wsparcie_c is [-3.00, 3.00]

SIMPLE SLOPES ANALYSIS

Slope of stres_c when wsparcie_c = -2.00:

  Est.   S.E.   t val.      p
------ ------ -------- ------
  2.41   0.33     7.35   0.00

Slope of stres_c when wsparcie_c =  0.00:

  Est.   S.E.   t val.      p
------ ------ -------- ------
  1.38   0.23     6.09   0.00

Slope of stres_c when wsparcie_c =  2.00:

  Est.   S.E.   t val.      p
------ ------ -------- ------
  0.36   0.35     1.02   0.34

               Estimate Std. Error t value Pr(>|t|)
(Intercept)       3.482      2.198   1.584    0.152
stres             3.430      0.540   6.347    0.000
wsparcie          0.745      0.504   1.478    0.178
stres:wsparcie   -0.511      0.127  -4.027    0.004
Checklista przed wysłaniem tekstu
- Hipoteza moderacji z kierunkiem (wzmacnia czy osłabia) zapisana przed analizą.
- Predyktor i moderator wycentrowane albo jasno podane, przy jakich wartościach obowiązują b1 i b2.
- Raportujesz b3 z 95% CI i ΔR².
- Proste nachylenia z CI przy M ± 1 SD (albo przy sensownych wartościach skali) i region Johnsona-Neymana z informacją, ile osób leży w każdym obszarze.
- Wykres prostych nachyleń z opisanymi liniami i założenia sprawdzone na resztach.
Pytania recenzentów
Czy muszę centrować zmienne przed interakcją?
Nie musisz – test b3 wyjdzie taki sam. Centrowanie sprawia jedynie, że b1 i b2 opisują efekty przy przeciętnych wartościach, czyli dają się sensownie zinterpretować.
M ± 1 SD czy Johnson-Neyman?
Najlepiej oba. Proste nachylenia dają czytelną tabelę, a region Johnsona-Neymana pokazuje cały zakres moderatora bez arbitralnych punktów (Preacher i in., 2006). Gdy M ± 1 SD wypada poza skalą, wybierz wartości z zakresu danych.
Ile osób potrzeba do moderacji?
Znacznie więcej niż do efektu głównego, bo interakcje są zwykle małe. Policz moc dla oczekiwanego ΔR² przed badaniem – zobacz analizę mocy do grantu i artykułu. Przykład z 12 osobami służy wyłącznie nauce.
Bibliografia
- Aiken, L. S., & West, S. G. (1991). Multiple regression: Testing and interpreting interactions. SAGE.
- Bauer, D. J., & Curran, P. J. (2005). Probing interactions in fixed and multilevel regression: Inferential and graphical techniques. Multivariate Behavioral Research, 40(3), 373–400. https://doi.org/10.1207/s15327906mbr4003_5
- Echambadi, R., & Hess, J. D. (2007). Mean-centering does not alleviate collinearity problems in moderated multiple regression models. Marketing Science, 26(3), 438–445.
- Hayes, A. F. (2022). Introduction to mediation, moderation, and conditional process analysis: A regression-based approach (3rd ed.). Guilford Press.
- Johnson, P. O., & Neyman, J. (1936). Tests of certain linear hypotheses and their application to some educational problems. Statistical Research Memoirs, 1, 57–93.
- Long, J. A. (2024). interactions: Comprehensive, user-friendly toolkit for probing interactions (Wersja 1.2.0) [Pakiet R]. https://doi.org/10.32614/CRAN.package.interactions
- Preacher, K. J., Curran, P. J., & Bauer, D. J. (2006). Computational tools for probing interactions in multiple linear regression, multilevel modeling, and latent curve analysis. Journal of Educational and Behavioral Statistics, 31(4), 437–448. https://doi.org/10.3102/10769986031004437
- Hryniewicz, K., & Milewska, A. (2023). SZTOS: System Zautomatyzowanego Tworzenia Opisu Statystycznego [Oprogramowanie]. SZTOS IT. https://sztos-it.com/
Zobacz też
- Słownik wzorówInterakcja w regresji (moderacja)
- PoradnikMediacja z bootstrapem – jak opisać wyniki
- Poradnikprzykladowe-raporty/analiza-moderacji-regresja.html
- Słownik wzorówRegresja hierarchiczna i ΔR²
- PoradnikSekcja „Analiza statystyczna” w artykule – jak napisać
- Przykładowy raportAnaliza regresji
Przygotowujesz artykuł, doktorat lub grant?
Zaplanujemy i wykonamy analizy, przygotujemy raport z tabelami, wykresami i kodem R oraz pomożemy odpowiedzieć na uwagi recenzentów dotyczące statystyki.