

Opis próby badawczej – Tabela 1 krok po kroku (z przykładem w R)
Opis próby badawczej to pierwszy akapit rozdziału wyników: kto wziął udział w badaniu, ile było osób i jakie miały cechy. Typowe pytanie z pracy dyplomowej: jak zrobić Tabelę 1 z płcią, wiekiem i kierunkiem studiów i co o niej napisać w tekście?
W prostych słowachDla cech, które mają kategorie (płeć, kierunek, rok studiów), podajesz liczbę osób i procent. Dla cech liczbowych, takich jak wiek, podajesz średnią z odchyleniem standardowym, a gdy rozkład jest krzywy – także medianę i zakres. Wszystko zbierasz w jednej tabeli, a w tekście opisujesz tylko najważniejsze liczby. Na tej podstawie czytelnik ocenia, do kogo można odnosić Twoje wnioski.
Krok 1. Co powinno się znaleźć w opisie próby?
- liczba osób (N) i informacja, ile ankiet odrzucono i dlaczego (np. niepełne odpowiedzi);
- cechy demograficzne: płeć, wiek, miejsce zamieszkania – tylko te, które pytałeś i które mają sens dla tematu;
- cechy ważne dla hipotez: np. kierunek i rok studiów, jeśli porównujesz te grupy;
- sposób doboru: gdzie i kiedy udostępniono ankietę (to zwykle piszesz w metodologii, w opisie próby wystarczy jedno zdanie).
Liczba osób, które powinieneś zbadać, to osobny temat – opisujemy go we wpisie ile osób przebadać do pracy magisterskiej. Tu zakładamy, że dane już masz, np. pobrane z Formularzy Google.
Krok 2. Dane – 10 osób z ankiety
Przykład jest celowo mały, żeby każde działanie dało się sprawdzić kalkulatorem. Tak samo liczysz Tabelę 1 dla 150 osób.
| Osoba | Płeć | Wiek | Kierunek | Rok studiów |
|---|---|---|---|---|
| 1 | kobieta | 21 | psychologia | III rok I st. |
| 2 | kobieta | 22 | psychologia | III rok I st. |
| 3 | mężczyzna | 22 | ekonomia | III rok I st. |
| 4 | kobieta | 23 | pedagogika | III rok I st. |
| 5 | mężczyzna | 23 | ekonomia | III rok I st. |
| 6 | kobieta | 23 | psychologia | I rok II st. |
| 7 | kobieta | 24 | pedagogika | I rok II st. |
| 8 | kobieta | 25 | psychologia | I rok II st. |
| 9 | mężczyzna | 26 | ekonomia | II rok II st. |
| 10 | kobieta | 31 | pedagogika | II rok II st. |
| Suma | 7 K, 3 M | 240 | 4 / 3 / 3 | 5 / 3 / 2 |
Krok 3. Liczymy n (%), M (SD) i Me
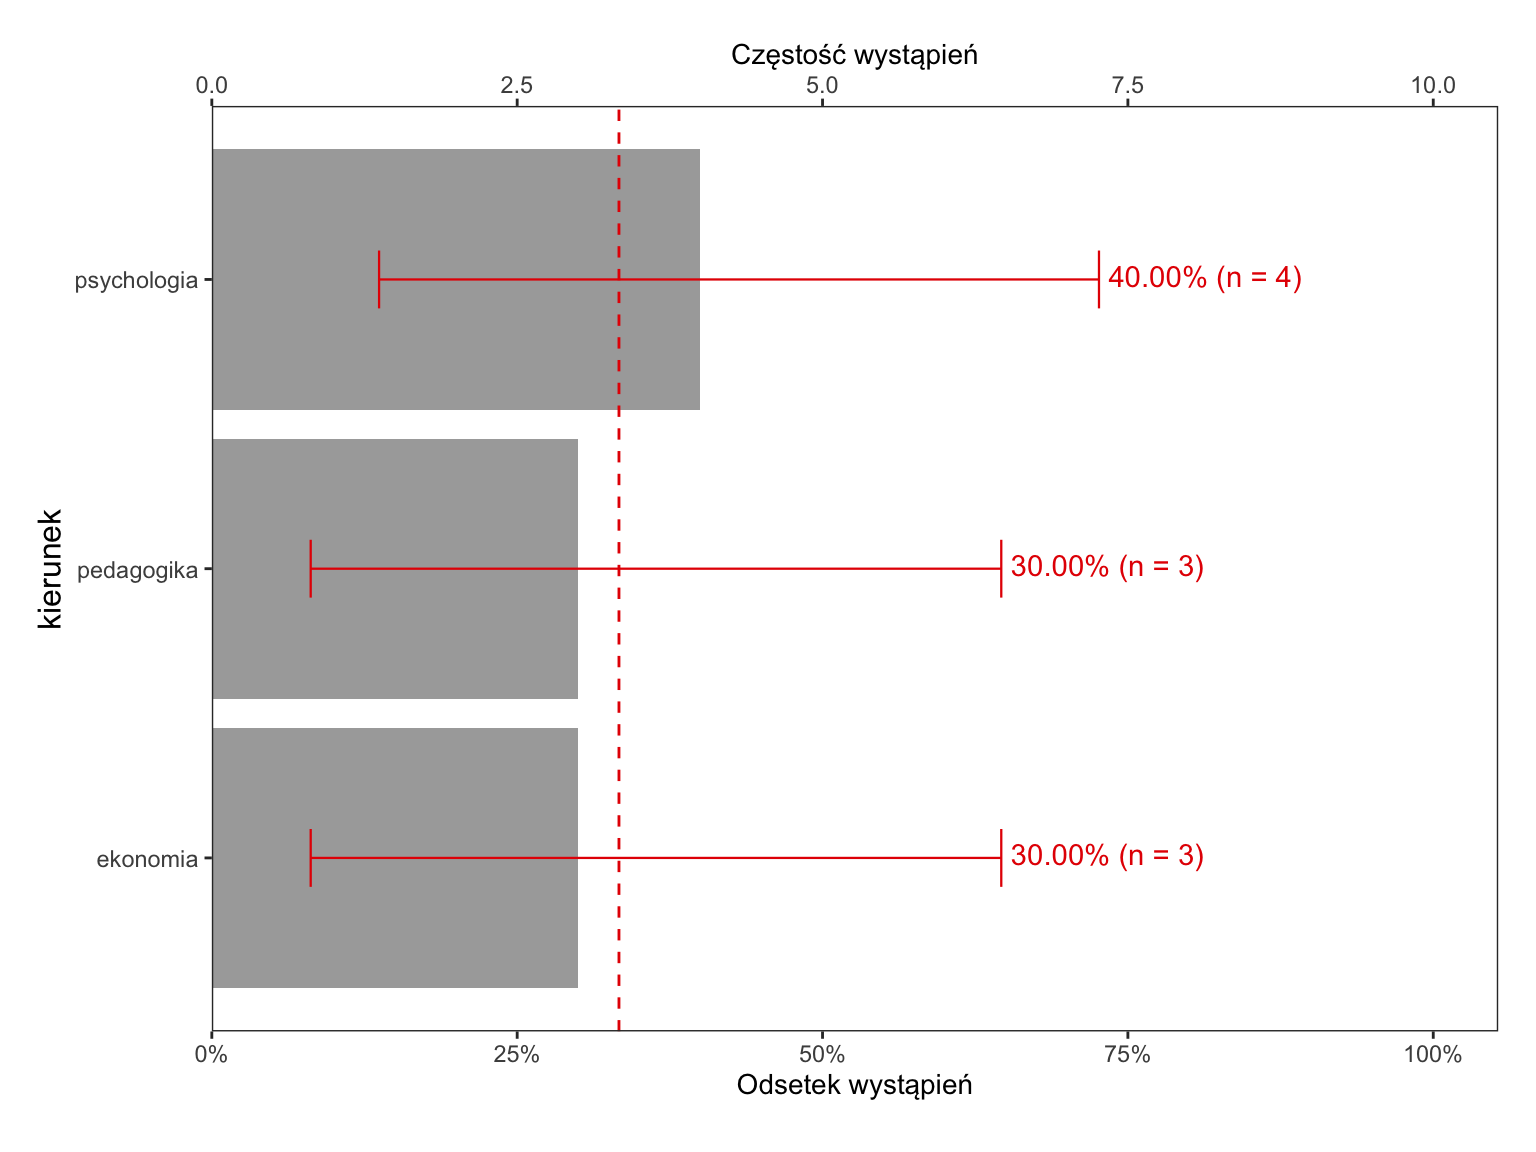
- Procenty. Kobiet jest 7 z 10: 7 / 10 = 0,7, czyli 70,0%. Mężczyzn: 3 / 10 = 30,0%. Tak samo kierunek (psychologia 4 / 10 = 40,0%, pedagogika i ekonomia po 30,0%) i rok studiów (50,0%, 30,0% i 20,0%). Procenty w każdej zmiennej sumują się do 100. Więcej o tym w haśle analiza częstości.
- Średnia wieku. Suma lat to 240, więc M = 240 / 10 = 24,00 roku.
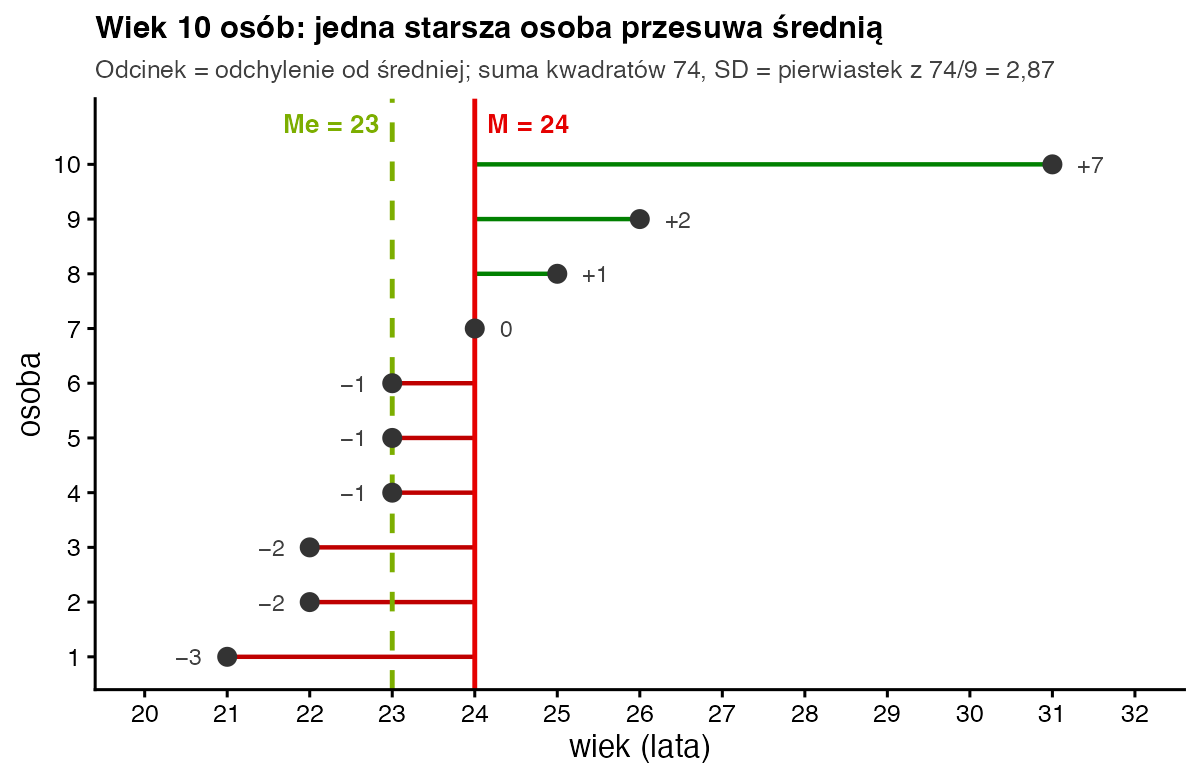
- Odchylenia od średniej. 21 − 24 = −3, 22 − 24 = −2 (dwa razy), 23 − 24 = −1 (trzy razy), 24 − 24 = 0, 25 − 24 = 1, 26 − 24 = 2 i 31 − 24 = 7.
- Kwadraty i ich suma. 9 + 4 + 4 + 1 + 1 + 1 + 0 + 1 + 4 + 49 = 74.
- Odchylenie standardowe. 74 / (10 − 1) = 74 / 9 = 8,22 (to wariancja), a pierwiastek z 8,22 to SD = 2,87. Dlaczego dzielimy przez 9, a nie przez 10, wyjaśnia hasło odchylenie standardowe.
- Mediana. Przy 10 osobach środek wypada między 5. a 6. wartością po uporządkowaniu: (23 + 23) / 2 = 23,00. Szczegóły w haśle mediana.
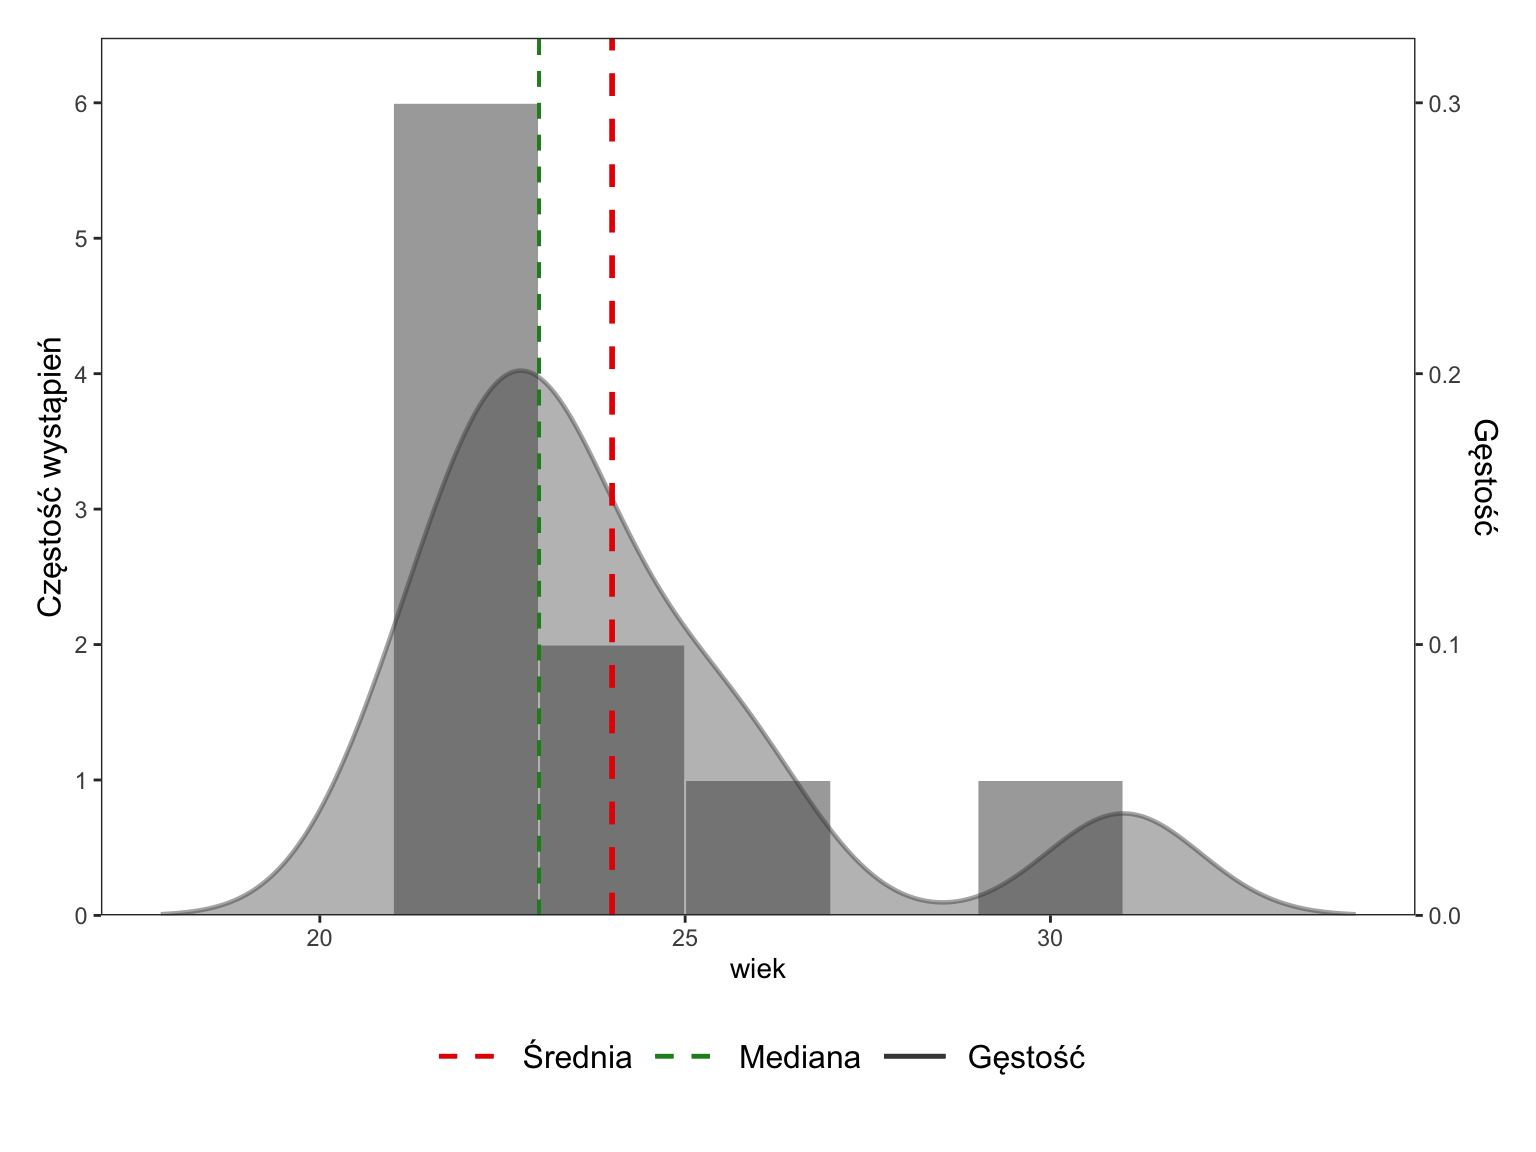
Średnia (24) jest wyższa od mediany (23), bo jedna osoba ma 31 lat i „ciągnie” średnią w górę (Rys. 1). Tak wygląda rozkład prawoskośny. W takiej sytuacji obok M i SD podaj medianę i zakres wieku.
Krok 4. Gotowa Tabela 1 do pracy
Tabela 1 ma tytuł nad tabelą, procenty z jednym miejscem po przecinku, a w nocie – objaśnienie skrótów (American Psychological Association, 2020). Więcej wzorów tabel znajdziesz we wpisie opis wyników w stylu APA 7.
| Zmienna | Kategoria | n (%) lub statystyka |
|---|---|---|
| Płeć | kobieta | 7 (70,0) |
| mężczyzna | 3 (30,0) | |
| Wiek (lata) | M (SD) | 24,00 (2,87) |
| Me (min–maks) | 23,00 (21–31) | |
| Kierunek studiów | psychologia | 4 (40,0) |
| pedagogika | 3 (30,0) | |
| ekonomia | 3 (30,0) | |
| Rok studiów | III rok I stopnia | 5 (50,0) |
| I rok II stopnia | 3 (30,0) | |
| II rok II stopnia | 2 (20,0) |
Nota pod tabelą: „n – liczba osób; M – średnia; SD – odchylenie standardowe; Me – mediana”.
Krok 5. Gotowy akapit opisu próby
Opis próby: W badaniu wzięło udział 10 studentów: 7 kobiet (70,0%) i 3 mężczyzn (30,0%). Wiek badanych wynosił od 21 do 31 lat (M = 24,00; SD = 2,87; Me = 23,00). Najliczniejszą grupę stanowili studenci psychologii (n = 4; 40,0%), a pozostali studiowali pedagogikę i ekonomię (po 3 osoby; 30,0%). Połowa badanych (n = 5) była na III roku studiów I stopnia. Szczegółową charakterystykę próby przedstawia Tabela 1.
Zwróć uwagę: akapit nie powtarza każdej liczby z tabeli. Wskazuje to, co najważniejsze, i odsyła do Tabeli 1. Jeśli odrzuciłeś ankiety, dopisz zdanie na początku, np. „Z 12 zebranych ankiet odrzucono 2 niepełne”.
Jak pokazać próbę na wykresie?
W pracy zwykle wystarczy tabela. Wykres przydaje się, gdy zmienna ma wiele kategorii albo chcesz pokazać kształt rozkładu wieku. Oba rysunki poniżej pochodzą z modułu częstości aplikacji SZTOS, uruchomionego na tych samych 10 osobach. Pełny raport tego typu zobaczysz w przykładowym raporcie z opisem próby.
Jak zrobić Tabelę 1 w R?
# Dane: 10 osób z ankiety (w praktyce: proba <- read.csv("ankieta.csv"))
proba <- data.frame(
  plec     = c("kobieta", "kobieta", "mężczyzna", "kobieta", "mężczyzna",
               "kobieta", "kobieta", "kobieta", "mężczyzna", "kobieta"),
  wiek     = c(21, 22, 22, 23, 23, 23, 24, 25, 26, 31),
  kierunek = c("psychologia", "psychologia", "ekonomia", "pedagogika", "ekonomia",
               "psychologia", "pedagogika", "psychologia", "ekonomia", "pedagogika"),
  rok      = rep(c("III rok I st.", "I rok II st.", "II rok II st."), times = c(5, 3, 2)))
proba$rok <- factor(proba$rok, levels = c("III rok I st.", "I rok II st.", "II rok II st."))

# 1) zmienne jakościowe: n i % (z jednym miejscem po przecinku)
czestosci <- function(x, nazwa) {
  t <- table(x)
  data.frame(Zmienna = nazwa, Kategoria = names(t),
             Wartosc = paste0(as.vector(t), " (", format(round(100 * prop.table(t), 1), nsmall = 1), "%)"))
}
# 2) zmienna ilościowa: M (SD), Me, min–maks
opis <- function(x, nazwa) {
  data.frame(Zmienna = nazwa, Kategoria = c("M (SD)", "Me", "min–maks"),
             Wartosc = c(sprintf("%.2f (%.2f)", mean(x), sd(x)), sprintf("%.2f", median(x)),
                         paste0(min(x), "–", max(x))))
}
# 3) sklejamy Tabelę 1
tabela1 <- rbind(czestosci(proba$plec, "Płeć"), opis(proba$wiek, "Wiek (lata)"),
                 czestosci(proba$kierunek, "Kierunek"), czestosci(proba$rok, "Rok studiów"))
print(tabela1, row.names = FALSE)
# Do Worda: write.csv2(tabela1, "tabela1.csv", row.names = FALSE)
Wynik w konsoli R:
     Zmienna     Kategoria      Wartosc
        Płeć       kobieta    7 (70.0%)
        Płeć     mężczyzna    3 (30.0%)
 Wiek (lata)        M (SD) 24.00 (2.87)
 Wiek (lata)            Me        23.00
 Wiek (lata)      min–maks        21–31
    Kierunek      ekonomia    3 (30.0%)
    Kierunek    pedagogika    3 (30.0%)
    Kierunek   psychologia    4 (40.0%)
 Rok studiów III rok I st.    5 (50.0%)
 Rok studiów  I rok II st.    3 (30.0%)
 Rok studiów II rok II st.    2 (20.0%)
R pisze kropkę dziesiętną i sortuje kategorie alfabetycznie (dlatego rok studiów zamieniliśmy na czynnik z ustaloną kolejnością). W pracy zamień kropki na przecinki.
Checklista Tabeli 1
- N w tytule tabeli zgadza się z liczbą osób w analizach.
- Procenty w każdej zmiennej sumują się do 100 (z dokładnością do zaokrągleń).
- Wiek ma M i SD, a przy krzywym rozkładzie także Me i zakres.
- Kategorie idą w logicznej kolejności (rok I, II, III), a nie alfabetycznie.
- Braki danych są opisane: „brak odpowiedzi” jako osobny wiersz albo informacja w nocie.
Czy w opisie próby trzeba liczyć test chi-kwadrat?
Zwykle nie. Opis próby to statystyka opisowa. Test chi-kwadrat zgodności (raport SZTOS podaje go automatycznie, np. dla płci χ²(1) = 1,60; p = 0,206) przydaje się tylko wtedy, gdy chcesz sprawdzić, czy proporcje różnią się od założonych, np. od struktury wszystkich studentów wydziału. Przy 10 osobach brak istotności nie oznacza, że płcie są równo reprezentowane – kobiet jest wyraźnie więcej.
Średnia czy mediana wieku – co podać?
Podaj średnią z odchyleniem standardowym, bo tego oczekuje większość promotorów i czasopism. Gdy średnia wyraźnie różni się od mediany albo zakres jest szeroki, dodaj medianę i min–maks. Nie zastępuj wieku samymi przedziałami („20–25 lat”), jeśli pytałeś o dokładną liczbę lat. Gotowe sformułowania do całego rozdziału znajdziesz we wpisie jak opisać wyniki ankiety w pracy magisterskiej.
Bibliografia
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). https://doi.org/10.1037/0000165-000
- Appelbaum, M., Cooper, H., Kline, R. B., Mayo-Wilson, E., Nezu, A. M., & Rao, S. M. (2018). Journal article reporting standards for quantitative research in psychology: The APA Publications and Communications Board task force report. American Psychologist, 73(1), 3–25. https://doi.org/10.1037/amp0000191
- Wilson, E. B. (1927). Probable inference, the law of succession, and statistical inference. Journal of the American Statistical Association, 22(158), 209–212. https://doi.org/10.1080/01621459.1927.10502953
- King, B. M., & Minium, E. W. (2009). Statystyka dla psychologów i pedagogów. Wydawnictwo Naukowe PWN.
- Hryniewicz, K., & Milewska, A. (2023). SZTOS: System Zautomatyzowanego Tworzenia Opisu Statystycznego [Oprogramowanie]. SZTOS IT. https://sztos-it.com/
Zobacz też
- Słownik wzorówCzęstości i procenty
- Słownik wzorówOdchylenie standardowe
- PoradnikOpis wyników w stylu APA 7 – gotowe zdania i tabele
- Przykładowy raportPrzykładowy raport SZTOS: opis próby
- PoradnikAnaliza statystyczna w pracy magisterskiej krok po kroku
Potrzebujesz pomocy z analizą do pracy dyplomowej?
Policzymy Twoje wyniki, przygotujemy tabele, wykresy i opis w standardzie APA, który wykorzystasz w swojej pracy. Pomagamy jak statystyk i redaktor – autorem pracy zostajesz Ty. Konsultacja i wycena są bezpłatne.