

Ile osób przebadać do pracy magisterskiej? Liczebność próby krok po kroku
Nie ma jednej liczby osób, która „wystarcza” do każdej pracy magisterskiej. Potrzebna liczebność próby zależy od tego, na jakie pytanie odpowiadasz: czy chcesz dokładnie oszacować odsetek, czy sprawdzić hipotezę o różnicy lub związku.
W prostych słowachNajpierw nazwij swój główny wynik. Jeśli to odsetek („ilu studentów korzysta z korepetycji”), liczysz margines błędu – przy ±5 punktach procentowych wychodzi 385 osób. Jeśli to porównanie grup albo korelacja, liczysz moc testu – dla średniej różnicy między dwiema grupami potrzebujesz 64 osób w każdej z nich. Obie liczby mają sens tylko wtedy, gdy wiesz, kogo i jak dobrałeś do badania.
Krok 1. Jakie jest Twoje główne pytanie?
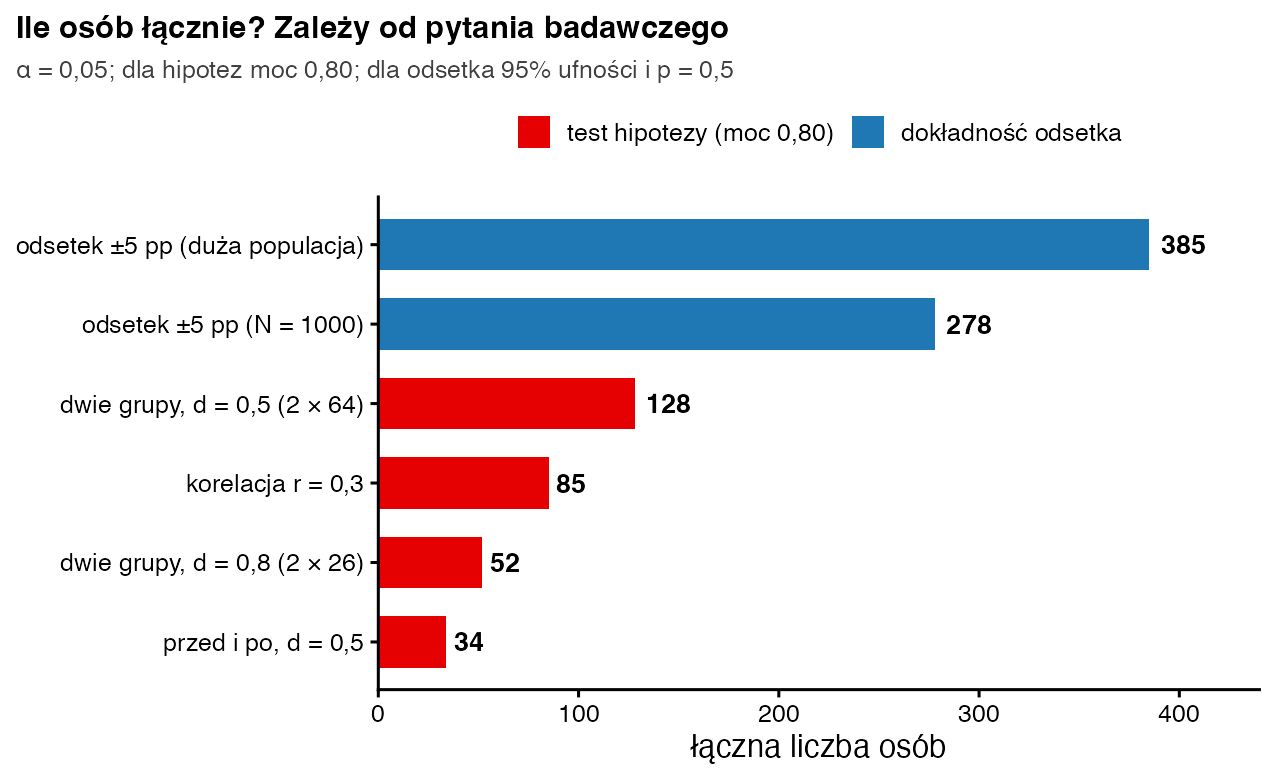
Zanim policzysz cokolwiek, zapisz jedno zdanie: „najważniejszym wynikiem mojej pracy będzie…”. Od tego zdania zależy wzór. Tabela pokazuje typowe sytuacje z prac dyplomowych. Wszystkie liczby dla hipotez dotyczą testu dwustronnego przy α = 0,05 i mocy 0,80.
| Główny wynik pracy | Co liczysz | Założenie | Ile osób |
|---|---|---|---|
| odsetek w dużej populacji | margines błędu | ±5 pp, 95% ufności, p = 0,5 | 385 |
| odsetek na wydziale (N = 1000) | margines błędu z poprawką | jak wyżej | 278 |
| różnica między dwiema grupami | moc testu t | efekt średni, d = 0,5 | 64 na grupę (128) |
| różnica między dwiema grupami | moc testu t | efekt duży, d = 0,8 | 26 na grupę (52) |
| pomiar przed i po u tych samych osób | moc testu t dla par | d = 0,5 dla różnic | 34 |
| związek dwóch zmiennych | moc testu korelacji | r = 0,3 | 85 |
Pytanie 1: jak dokładny ma być odsetek?
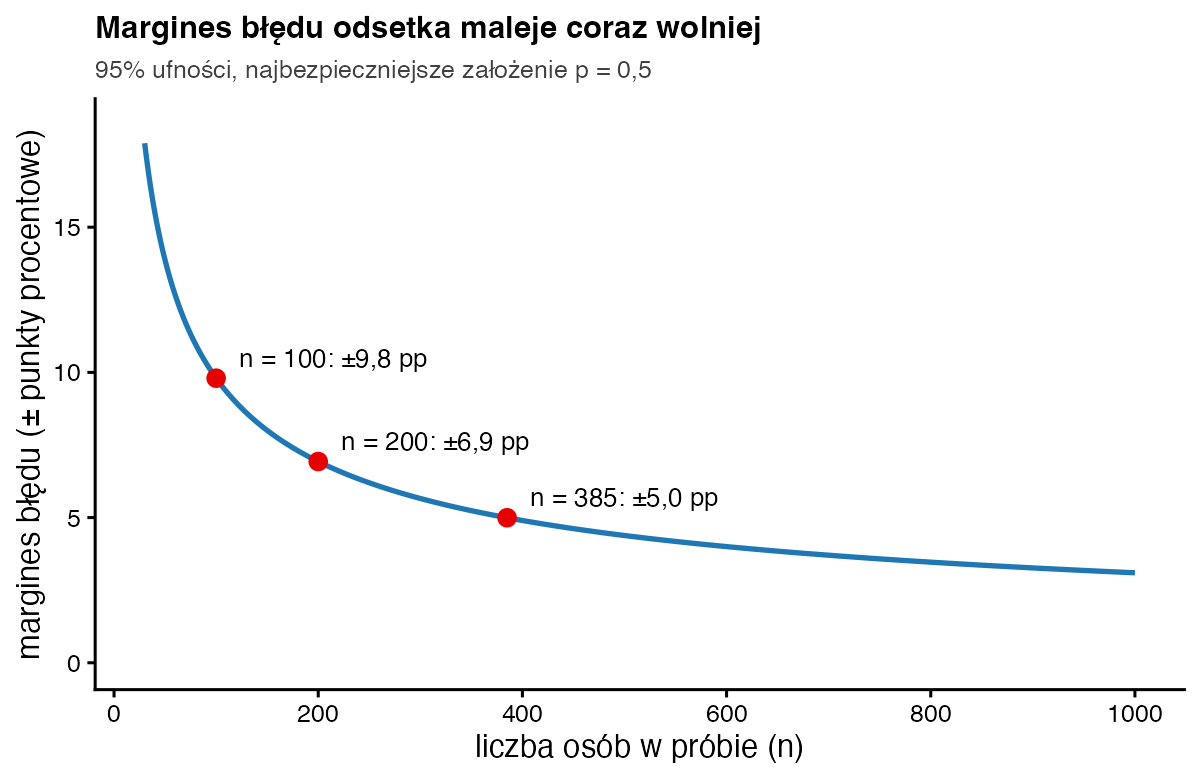
Gdy głównym wynikiem jest procent odpowiedzi, wybierasz margines błędu, np. ±5 punktów procentowych przy 95% ufności. Jeśli nie wiesz, jakiego odsetka się spodziewać, przyjmujesz najbezpieczniejsze p = 0,5. Wtedy wychodzi 384,16, czyli po zaokrągleniu w górę 385 osób. Gdy cała populacja jest mała, np. 1000 studentów jednego wydziału, poprawka na populację skończoną obniża tę liczbę do 278. Każde działanie rozpisaliśmy w haśle margines błędu i liczebność próby.
Wzór działa też w drugą stronę. Jeśli zebrałeś 100 ankiet, margines wynosi około ±9,8 punktu, a przy 200 ankietach – ±6,9 punktu (Rys. 1). Taką informację możesz uczciwie podać w pracy zamiast szukać „magicznej” liczby. Szczegóły obliczeń znajdziesz w haśle o przedziale ufności dla proporcji.
Pytanie 2: czy test wykryje różnicę, jeśli ona istnieje?
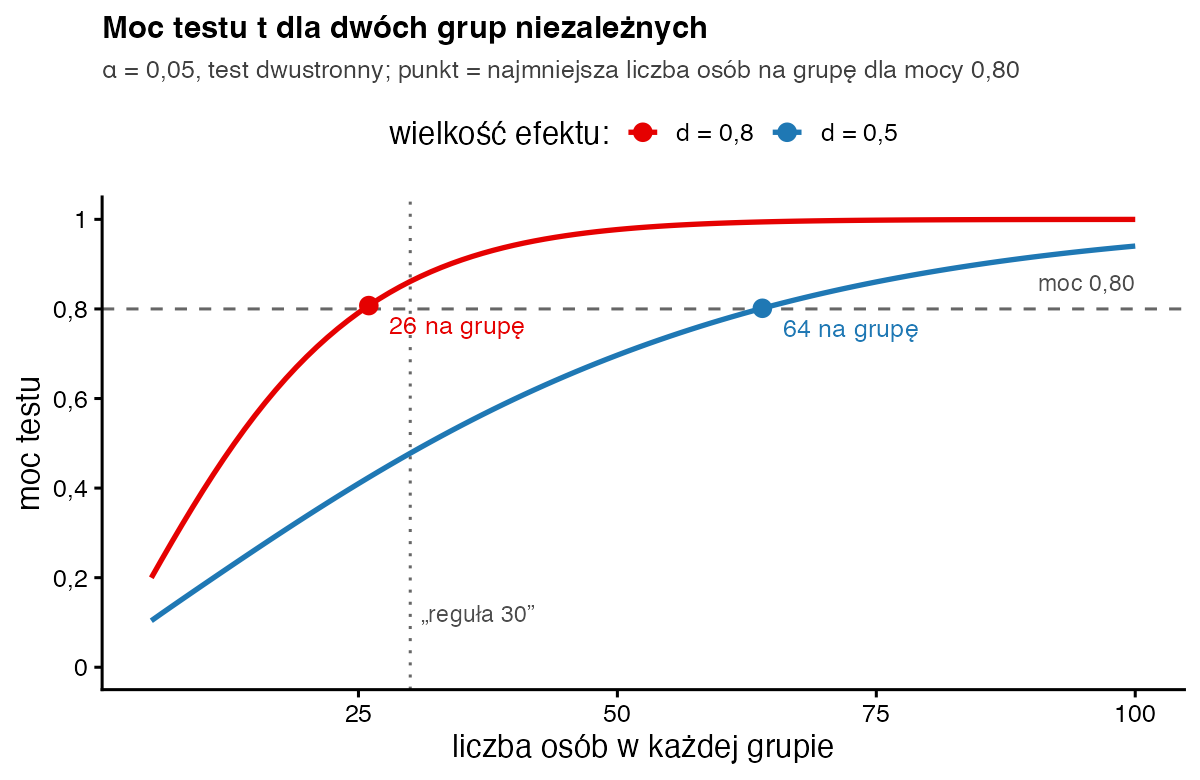
Większość prac magisterskich ma hipotezy typu „kobiety i mężczyźni różnią się poziomem stresu” albo „sen wiąże się z wynikami”. Wtedy margines błędu nic nie mówi. Liczysz moc testu, czyli szansę, że test wykaże istotny wynik, jeśli efekt naprawdę ma założoną wielkość. Przyjęło się planować moc 0,80 (Cohen, 1988). Brakująca moc to ryzyko błędu drugiego rodzaju.
Musisz też założyć wielkość efektu. Najlepiej wziąć ją z podobnego badania. Jeśli takiego nie ma, możesz odwołać się do umownych progów d Cohena: 0,2 – mały, 0,5 – średni, 0,8 – duży. Funkcja power.t.test w R podaje, że dla d = 0,5 potrzeba 63,77 osoby na grupę, czyli 64, a dla d = 0,8 – 25,52, czyli 26. Mały efekt d = 0,2 wymagałby aż 394 osób na grupę. Dlatego w pracy magisterskiej zwykle uczciwiej jest planować efekt średni lub duży i napisać, że małego efektu badanie mogło nie wykryć.
Reguły kciuka i ich granice
- „30 osób na grupę”. Ta liczba pochodzi z rozważań o centralnym twierdzeniu granicznym, a nie z analizy mocy. Wystarcza dla efektu dużego (moc 0,86), ale przy efekcie średnim moc to tylko 0,48 – rzut monetą.
- „10% populacji”. Nie ma podstaw. Margines błędu zależy od liczby badanych, a nie od tego, jaką część populacji stanowią.
- „50 + 8k” w regresji. Green (1991) proponuje co najmniej 50 + 8k osób do testu całego modelu (k – liczba predyktorów), a 104 + k do testowania pojedynczych współczynników regresji. Dla 3 predyktorów to 74 i 107 osób. Reguła zakłada efekt średni.
- „Im więcej, tym lepiej”. Większa próba z tego samego wygodnego źródła zmniejsza tylko przypadkowe wahania, nie usuwa skrzywienia doboru.
Co napisać w metodologii?
Podaj, czego dotyczy obliczenie, jakie wartości przyjąłeś i skąd je wziąłeś (Lakens, 2022). Wystarczą dwa zdania.
Dla odsetka: Minimalną liczebność próby wyznaczono dla oszacowania odsetka przy poziomie ufności 95%, marginesie błędu ±5 punktów procentowych i zachowawczym założeniu p = 0,50. Po uwzględnieniu poprawki na populację skończoną (N = 1000) wymagana liczebność wyniosła 278 osób.
Dla hipotezy: Analiza mocy dla testu t dla prób niezależnych (α = 0,05, test dwustronny, moc 0,80) wykazała, że wykrycie efektu średniej wielkości (d = 0,5; Cohen, 1988) wymaga 64 osób w każdej grupie.
Jeśli zebrałeś mniej osób, nie ukrywaj tego. Napisz, jaki efekt badanie było w stanie wykryć, i wróć do tego w ograniczeniach. Gdy wynik okaże się nieistotny, pomoże Ci wpis hipotezy się nie potwierdziły – co napisać. Szerzej o planowaniu mocy piszemy w poradniku analiza mocy do grantu i artykułu.
Próba dostępności – co z nią zrobić?
Większość studentów zbiera dane wśród znajomych, na grupach wydziałowych lub w mediach społecznościowych. To próba dostępności (wygodna). Wzór na margines błędu zakłada losowanie, więc przy takiej próbie 385 osób nie czyni wyników „reprezentatywnymi”. Nie dyskwalifikuje to pracy. Opisz dokładnie, kto odpowiedział i gdzie była udostępniona ankieta, a wnioski odnoś do podobnych osób, a nie do „wszystkich Polaków”. Pomogą Ci wpisy gdzie zrobić ankietę i jak przygotować ankietę, a opis zebranej grupy pokazuje Tabela 1 z opisem próby.
Jak policzyć liczebność próby w R?
# Pytanie 1: ile osób, żeby odsetek miał margines ±5 pp (95% ufności, p = 0,5)?
z  <- qnorm(0.975)                      # 1,96
n0 <- z^2 * 0.5 * (1 - 0.5) / 0.05^2    # duża populacja
N  <- 1000                              # np. wszyscy studenci wydziału
c(n0 = ceiling(n0), n_N1000 = ceiling(n0 / (1 + (n0 - 1) / N)))

# Jaki margines daje próba, którą naprawdę zebrałeś?
n <- c(100, 200, 385)
round(100 * z * sqrt(0.25 / n), 1)      # w punktach procentowych

# Pytanie 2: ile osób na grupę, żeby test t wykrył efekt d z mocą 0,80?
sapply(c(d0.2 = 0.2, d0.5 = 0.5, d0.8 = 0.8), function(d)
  ceiling(power.t.test(delta = d, sd = 1, power = 0.80, sig.level = 0.05)$n))

# Jaką moc ma popularna „reguła 30 osób na grupę”?
round(sapply(c(d0.5 = 0.5, d0.8 = 0.8), function(d)
  power.t.test(n = 30, delta = d, sd = 1)$power), 2)

# Ta sama osoba mierzona dwa razy (przed i po), d = 0,5
ceiling(power.t.test(delta = 0.5, sd = 1, power = 0.80, type = "paired")$n)

# Korelacja r = 0,3 (przybliżenie przez transformację Fishera)
ceiling(((qnorm(0.975) + qnorm(0.80)) / atanh(0.3))^2 + 3)
Wynik w konsoli R:
     n0 n_N1000
    385     278
[1] 9.8 6.9 5.0
d0.2 d0.5 d0.8
 394   64   26
d0.5 d0.8
0.48 0.86
[1] 34
[1] 85
Ostatnia liczba (85) to przybliżenie przez transformację Fishera. Program G*Power daje podobny wynik (Faul i in., 2007).
Checklista przed zbieraniem danych
- Zapisałem główny wynik pracy: odsetek, różnica czy związek.
- Wiem, skąd biorę wielkość efektu (wcześniejsze badanie albo próg Cohena).
- Policzyłem liczbę osób i dodałem ok. 10–20% zapasu na niepełne ankiety.
- Przy porównaniach grup sprawdziłem, czy w mniejszej grupie zbiorę wystarczająco osób.
- Opisałem sposób doboru próby i jego ograniczenia.
Czy 100 osób wystarczy do pracy magisterskiej?
Do porównania dwóch grup po 50 osób – wystarczy, jeśli efekt jest raczej duży, ale dla d = 0,5 moc wyniesie tylko 0,70. Do korelacji r = 0,3 – tak, bo potrzeba 85 osób. Do oszacowania odsetka – tak, ale z marginesem ok. ±9,8 punktu. O tym, czy wystarczy, decyduje cel, a nie sama liczba. Promotor może mieć też własne oczekiwania, więc ustal je wcześniej.
Ile osób do ankiety na licencjat?
Zasady są te same, ale prace licencjackie częściej mają charakter opisowy. Jeśli nie testujesz hipotez, wystarczy podać margines błędu dla liczby osób, którą realnie możesz zebrać, i opisać próbę.
Bibliografia
- Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates.
- Faul, F., Erdfelder, E., Lang, A.-G., & Buchner, A. (2007). G*Power 3: A flexible statistical power analysis program for the social, behavioral, and biomedical sciences. Behavior Research Methods, 39(2), 175–191. https://doi.org/10.3758/BF03193146
- Green, S. B. (1991). How many subjects does it take to do a regression analysis? Multivariate Behavioral Research, 26(3), 499–510. https://doi.org/10.1207/s15327906mbr2603_7
- Lakens, D. (2022). Sample size justification. Collabra: Psychology, 8(1), Article 33267. https://doi.org/10.1525/collabra.33267
- King, B. M., & Minium, E. W. (2009). Statystyka dla psychologów i pedagogów. Wydawnictwo Naukowe PWN.
- Hryniewicz, K., & Milewska, A. (2023). SZTOS: System Zautomatyzowanego Tworzenia Opisu Statystycznego [Oprogramowanie]. SZTOS IT. https://sztos-it.com/
Zobacz też
- Słownik wzorówMargines błędu i liczebność próby
- Słownik wzorówBłąd II rodzaju (β) i moc testu
- PoradnikGdzie zrobić ankietę do pracy magisterskiej
- PoradnikJak przygotować ankietę do pracy magisterskiej
- PoradnikAnaliza statystyczna w pracy magisterskiej krok po kroku
- Przykładowy raportOpis próby
Potrzebujesz pomocy z analizą do pracy dyplomowej?
Policzymy Twoje wyniki, przygotujemy tabele, wykresy i opis w standardzie APA, który wykorzystasz w swojej pracy. Pomagamy jak statystyk i redaktor – autorem pracy zostajesz Ty. Konsultacja i wycena są bezpłatne.