

Korelacja punktowo-dwuseryjna – wzór i przykład
Korelacja punktowo-dwuseryjna (\(r_{pb}\), ang. point-biserial) mierzy związek między zmienną dwuwartościową (np. grupa, płeć, zaliczył/nie zaliczył) a zmienną ilościową. Przykładowe pytanie z pracy dyplomowej: czy sposób nauki (notatki albo quizy) wiąże się z liczbą punktów z kolokwium?
W prostych słowachTo zwykła korelacja Pearsona, tylko jedna zmienna ma dwie wartości zakodowane jako 0 i 1. Wynik jest wysoki, gdy grupy mają wyraźnie różne średnie, a w każdej grupie wyniki są do siebie podobne. Znak zależy od kodowania: zamiana 0 i 1 zmienia tylko znak, nie siłę. W praktyce to ta sama informacja co w teście t dla dwóch grup, tylko podana w skali od −1 do 1.
Kiedy stosować korelację punktowo-dwuseryjną?
- jedna zmienna ma dokładnie dwie kategorie, które naprawdę są dwiema grupami (metoda A/B, kobiety/mężczyźni, pracuje/nie pracuje);
- druga zmienna jest ilościowa (punkty, czas, wynik skali);
- chcesz podać siłę związku w skali korelacji, np. w jednej macierzy korelacji z innymi zmiennymi;
- do testu istotności obowiązują te same założenia co w teście t Studenta dla prób niezależnych: rozkład w grupach zbliżony do normalnego i podobne wariancje.
Uwaga na pomyłkę w nazwie. Korelacja dwuseryjna (bez „punktowo”) zakłada, że pod dwiema kategoriami kryje się ciągła cecha o rozkładzie normalnym, którą sztucznie przecięto, np. „zdał/nie zdał” zamiast wyniku egzaminu. To inny wzór i inne wartości. Gdy wynik w grupach jest silnie skośny albo ma obserwacje odstające, lepszy będzie test U Manna-Whitneya z korelacją rangowo-dwuseryjną.
Wzór na korelację punktowo-dwuseryjną
Na głos: „różnica średnich grup podzielona przez odchylenie standardowe wszystkich wyników, pomnożona przez czynnik zależny od liczebności grup”.
- \(\bar{y}_1,\ \bar{y}_0\)
- średnie zmiennej ilościowej w grupie zakodowanej jako 1 i jako 0
- \(s_y\)
- odchylenie standardowe wszystkich wyników razem (z dzieleniem przez n − 1), bez podziału na grupy
- \(n_1,\ n_0,\ n\)
- liczebność grupy 1, grupy 0 i całej próby
- pierwiastek
- poprawka na proporcje grup: największa, gdy grupy są równe
- \(t,\ df\)
- statystyka testu t Studenta (wersja z równymi wariancjami) i jej stopnie swobody – druga wersja wzoru pozwala przeliczyć wynik testu t na korelację
Przykład krok po kroku
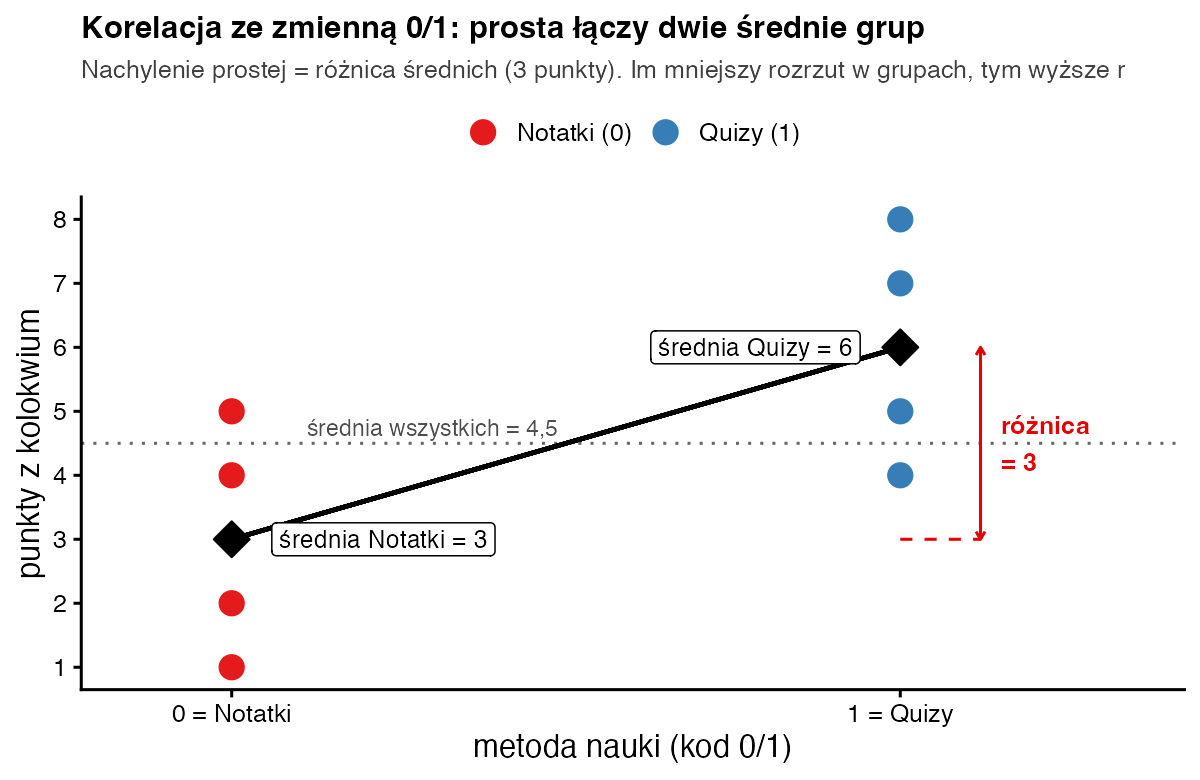
Dziesięcioro studentów przygotowywało się do kolokwium jedną z dwóch metod. Pięć osób robiło notatki (kod 0), pięć rozwiązywało quizy (kod 1). Średnia wszystkich wyników to 45 / 10 = 4,5 punktu.
| metoda | kod | punkty y | y − 4,5 | (y − 4,5)² |
|---|---|---|---|---|
| Notatki | 0 | 1 | −3,5 | 12,25 |
| Notatki | 0 | 2 | −2,5 | 6,25 |
| Notatki | 0 | 3 | −1,5 | 2,25 |
| Notatki | 0 | 4 | −0,5 | 0,25 |
| Notatki | 0 | 5 | 0,5 | 0,25 |
| Quizy | 1 | 4 | −0,5 | 0,25 |
| Quizy | 1 | 5 | 0,5 | 0,25 |
| Quizy | 1 | 6 | 1,5 | 2,25 |
| Quizy | 1 | 7 | 2,5 | 6,25 |
| Quizy | 1 | 8 | 3,5 | 12,25 |
| suma | 5 | 45 | 0 | 42,5 |
- Średnie grup. Notatki: (1 + 2 + 3 + 4 + 5) / 5 = 15 / 5 = 3. Quizy: (4 + 5 + 6 + 7 + 8) / 5 = 30 / 5 = 6. Różnica: 6 − 3 = 3 punkty.
- Odchylenie standardowe wszystkich wyników. Suma kwadratów odchyleń z tabeli to 42,5. Dzielimy przez n − 1 = 9: 42,5 / 9 = 4,722. Pierwiastek: \(s_y = \sqrt{4{,}722} = 2{,}173\).
- Różnica w jednostkach odchylenia. 3 / 2,173 = 1,381.
- Poprawka na liczebności. \(n_1 \cdot n_0 = 5 \cdot 5 = 25\), a \(n(n-1) = 10 \cdot 9 = 90\). Pierwiastek z 25 / 90 = 0,278 to 0,527.
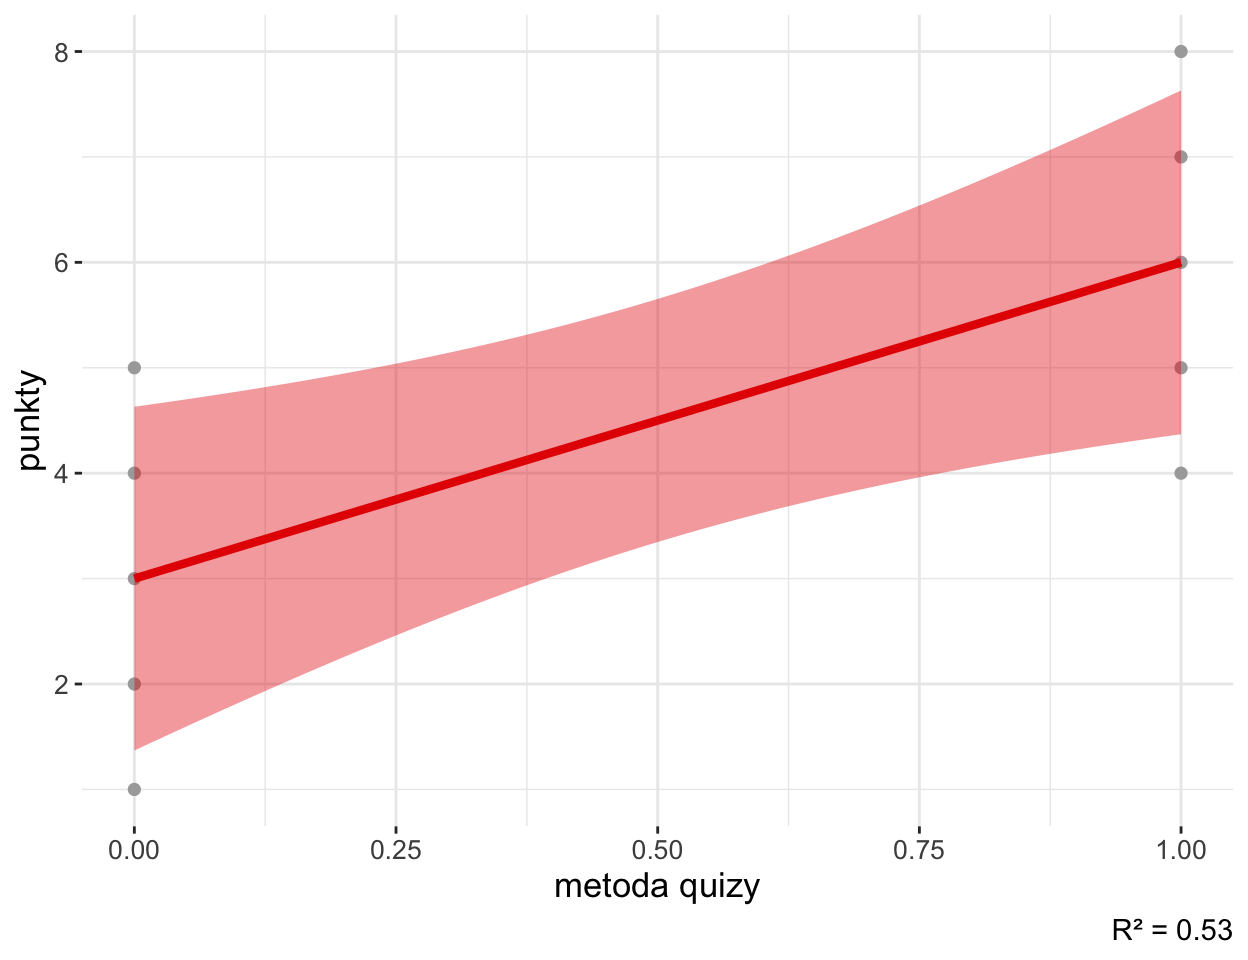
- Korelacja. \(r_{pb} = 1{,}381 \cdot 0{,}527 = 0{,}73\). Związek jest silny i dodatni: osoby z kodem 1 (quizy) mają wyższe wyniki.
- Sprawdzenie przez test t. Test t dla tych samych grup daje t = 3,00 przy df = 8. Wtedy \(r_{pb} = \sqrt{9/(9 + 8)} = \sqrt{9/17} = \sqrt{0{,}529} = 0{,}73\). Wynik ten sam.
- Istotność. Wartość krytyczna t dla df = 8 i α = 0,05 (dwustronnie) to 2,306 (tablice t albo w R:
qt(0.975, 8)). Nasze t = 3,00 jest większe, p = 0,017. - Procent wspólnej zmienności. \(r^2 = 0{,}529\), czyli metoda nauki „wyjaśnia” około 53% zmienności punktów w tej małej próbie.
Jak zinterpretować i opisać wynik?
Siłę związku oceniasz jak każdą korelację. Według Cohena (1988) około 0,10 to efekt mały, 0,30 – średni, a 0,50 i więcej – duży. Nasze 0,73 to efekt duży. Pamiętaj jednak o szerokim przedziale ufności dla korelacji: od 0,18 do 0,93. Przy 10 osobach prawdziwa siła związku może być zarówno umiarkowana, jak i bardzo duża. Znak zawsze opisuj słowami („wyższe wyniki w grupie quizów”), bo sam znak zależy od tego, którą grupę zakodowano jako 1.
Zapis w stylu APA: Metoda nauki była istotnie związana z liczbą punktów z kolokwium; osoby uczące się z quizami uzyskały wyższe wyniki niż osoby robiące notatki, rpb(8) = 0,73; 95% CI [0,18; 0,93]; p = 0,017.
Jak policzyć korelację punktowo-dwuseryjną w R?
punkty <- c(1, 2, 3, 4, 5, 4, 5, 6, 7, 8)
quizy  <- c(0, 0, 0, 0, 0, 1, 1, 1, 1, 1)     # 0 = Notatki, 1 = Quizy

# 1) „ręcznie”, dokładnie według wzoru
M1 <- mean(punkty[quizy == 1]); M0 <- mean(punkty[quizy == 0])   # 6 i 3
n1 <- sum(quizy == 1); n0 <- sum(quizy == 0); n <- n1 + n0
s  <- sd(punkty)                                                 # 2.173
(M1 - M0) / s * sqrt(n1 * n0 / (n * (n - 1)))                    # 0.7276

# 2) to po prostu korelacja Pearsona ze zmienną 0/1
cor.test(quizy, punkty)

# 3) to samo z testu t: r = sqrt(t^2 / (t^2 + df))
t <- t.test(punkty ~ quizy, var.equal = TRUE)$statistic
sqrt(t^2 / (t^2 + 8))
Wynik w konsoli R:
[1] 0.7276069

	Pearson's product-moment correlation

data:  quizy and punkty
t = 3, df = 8, p-value = 0.01707
alternative hypothesis: true correlation is not equal to 0
95 percent confidence interval:
 0.1808161 0.9308101
sample estimates:
      cor
0.7276069

        t
0.7276069
Zwróć uwagę: cor.test() daje t = 3 i p = 0,017 – dokładnie to samo, co test t Studenta. Korelacja punktowo-dwuseryjna i test t to dwa sposoby opisania tej samej różnicy.
Korelacja punktowo-dwuseryjna a d Cohena
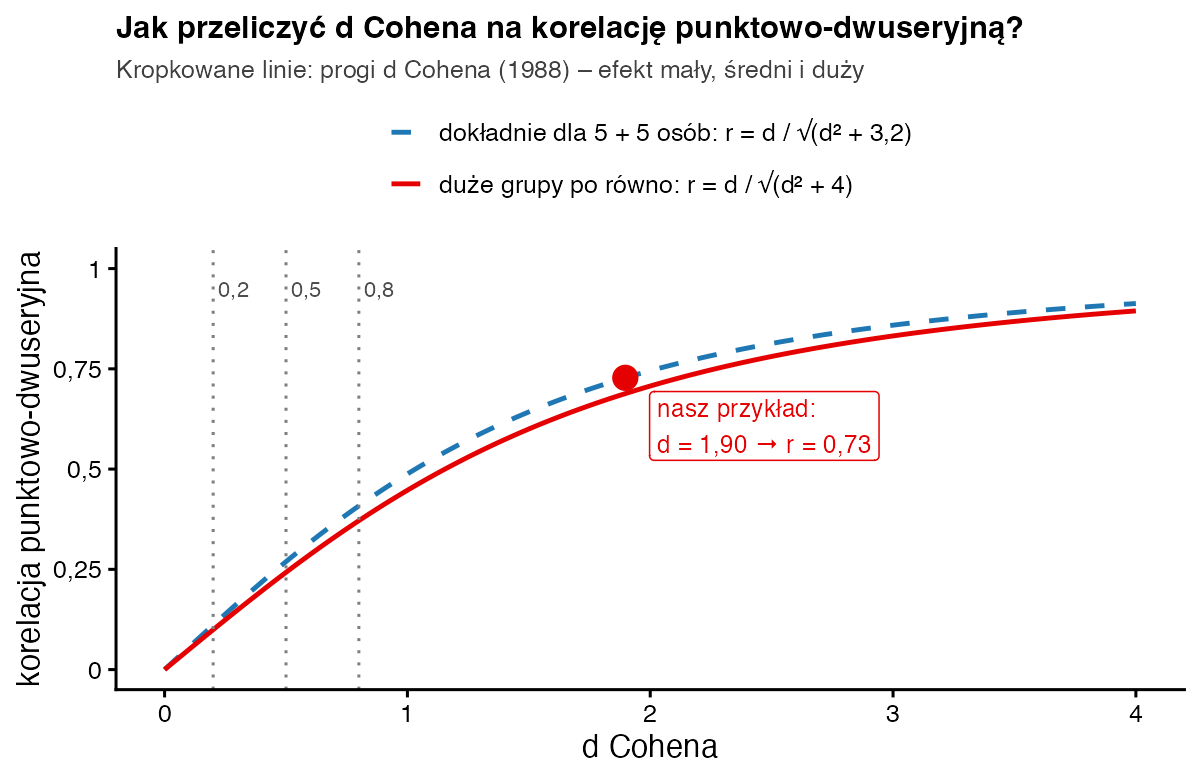
Obie miary opisują siłę różnicy między dwiema grupami, tylko w innych skalach. d Cohena mówi, o ile odchyleń standardowych różnią się średnie. U nas d = 1,90. Korelacja punktowo-dwuseryjna przelicza to na skalę od −1 do 1. Dokładny wzór to \(r = d/\sqrt{d^2 + (n^2 - 2n)/(n_1 n_0)}\). Dla naszych liczb: d² = 3,6, a (100 − 20) / 25 = 3,2, więc r = 1,90 / √6,8 = 0,73. Dla dużych i równych grup wzór upraszcza się do \(r = d/\sqrt{d^2 + 4}\). Dlatego progi d Cohena 0,2; 0,5 i 0,8 odpowiadają mniej więcej korelacjom 0,10; 0,24 i 0,37 – a nie 0,10; 0,30 i 0,50.
Najczęstsze błędy
- Mylenie korelacji punktowo-dwuseryjnej z dwuseryjną – to różne wzory i różne założenia.
- Interpretowanie znaku bez sprawdzenia, która grupa ma kod 1.
- Pomijanie informacji, że grupy mają bardzo różne liczebności – przy podziale 9 : 1 korelacja wychodzi niższa przy tej samej różnicy średnich.
- Raportowanie rpb i testu t jako dwóch niezależnych wyników – to ta sama informacja.
- Stosowanie progów Cohena dla korelacji do d i odwrotnie.
Bibliografia
- Tate, R. F. (1954). Correlation between a discrete and a continuous variable. Point-biserial correlation. The Annals of Mathematical Statistics, 25(3), 603–607.
- Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates.
- Field, A., Miles, J., & Field, Z. (2012). Discovering statistics using R. SAGE.
- King, B. M., & Minium, E. W. (2009). Statystyka dla psychologów i pedagogów. Wydawnictwo Naukowe PWN.
- Hryniewicz, K., & Milewska, A. (2023). SZTOS: System Zautomatyzowanego Tworzenia Opisu Statystycznego [Oprogramowanie]. SZTOS IT. https://sztos-it.com/
Zobacz też
- Słownik wzorówKorelacja Pearsona
- Słownik wzorówTest t Studenta dla prób niezależnych
- Słownik wzorówd Cohena – wielkość efektu
- PoradnikKorelacja Pearsona – przykład
- Słownik wzorówSłownik wzorów statystycznych – wszystkie hasła
- Przykładowy raportAnaliza korelacji
Potrzebujesz pomocy z analizą do pracy dyplomowej?
Policzymy Twoje wyniki, przygotujemy tabele, wykresy i opis w standardzie APA, który wykorzystasz w swojej pracy. Pomagamy jak statystyk i redaktor – autorem pracy zostajesz Ty. Konsultacja i wycena są bezpłatne.