

Test t a test z – czym się różnią i kiedy który wybrać
Test z i test t odpowiadają na to samo pytanie: czy średnie różnią się bardziej, niż mogłyby przez przypadek. Różnią się tym, skąd biorą odchylenie standardowe – i dlatego mają inne wartości krytyczne i inne p. Typowe pytanie z pracy dyplomowej: dlaczego promotor każe liczyć test t, skoro w podręczniku jest wzór na z?
W prostych słowachTest z zakłada, że prawdziwy rozrzut wyników w populacji znasz z góry, na przykład z norm testu. Test t ten rozrzut szacuje z tych samych kilku osób, które właśnie zbadałeś. Szacunek z małej próby bywa chybiony, więc test t jest ostrożniejszy: wymaga większej różnicy, żeby uznać ją za istotną. Im więcej osób, tym lepszy szacunek i tym mniejsza różnica między oboma testami.
Kiedy test z, a kiedy test t?
- test z: odchylenie standardowe populacji σ jest znane z zewnątrz (normy testu inteligencji, wieloletnie dane z egzaminu) – w pracach dyplomowych zdarza się to rzadko;
- test z jako przybliżenie: bardzo duże próby (setki osób), gdzie rozkład t prawie nie różni się od normalnego, oraz testy dla proporcji – zobacz test z dla dwóch proporcji;
- test t: odchylenie liczysz z próby – czyli prawie zawsze, gdy porównujesz średnie z ankiety czy eksperymentu;
- test t szczególnie przy małych grupach (kilka–kilkadziesiąt osób), bo tam różnica między testami jest największa.
W praktyce wybierasz więc odmianę testu t: dla prób niezależnych, dla prób zależnych albo dla jednej próby. Kształt rozkładu t i rolę stopni swobody wyjaśnia hasło rozkład t Studenta i stopnie swobody.
Wzór na test z i test t (dwie grupy)
- \(\bar{x}_1,\ \bar{x}_2\)
- średnie w grupie 1 i 2 – licznik jest w obu wzorach taki sam
- \(\sigma\)
- (sigma) odchylenie standardowe w populacji, znane przed badaniem
- \(s_p\)
- odchylenie połączone, policzone z próby: pierwiastek ze średniej ważonej wariancji obu grup
- \(n_1,\ n_2\)
- liczba osób w każdej grupie
- \(df\)
- stopnie swobody – mówią, z którego rozkładu t odczytać p; test z ich nie potrzebuje, bo zawsze korzysta z rozkładu normalnego
Na głos: „z (albo t) to różnica średnich podzielona przez jej błąd standardowy; w z błąd liczymy ze znanej sigmy, w t – z odchylenia z próby”. Dla jednej próby wzory są analogiczne: \( z = (\bar{x} - \mu_0) / (\sigma / \sqrt{n}) \), a w t zamiast σ jest s.
Przykład krok po kroku
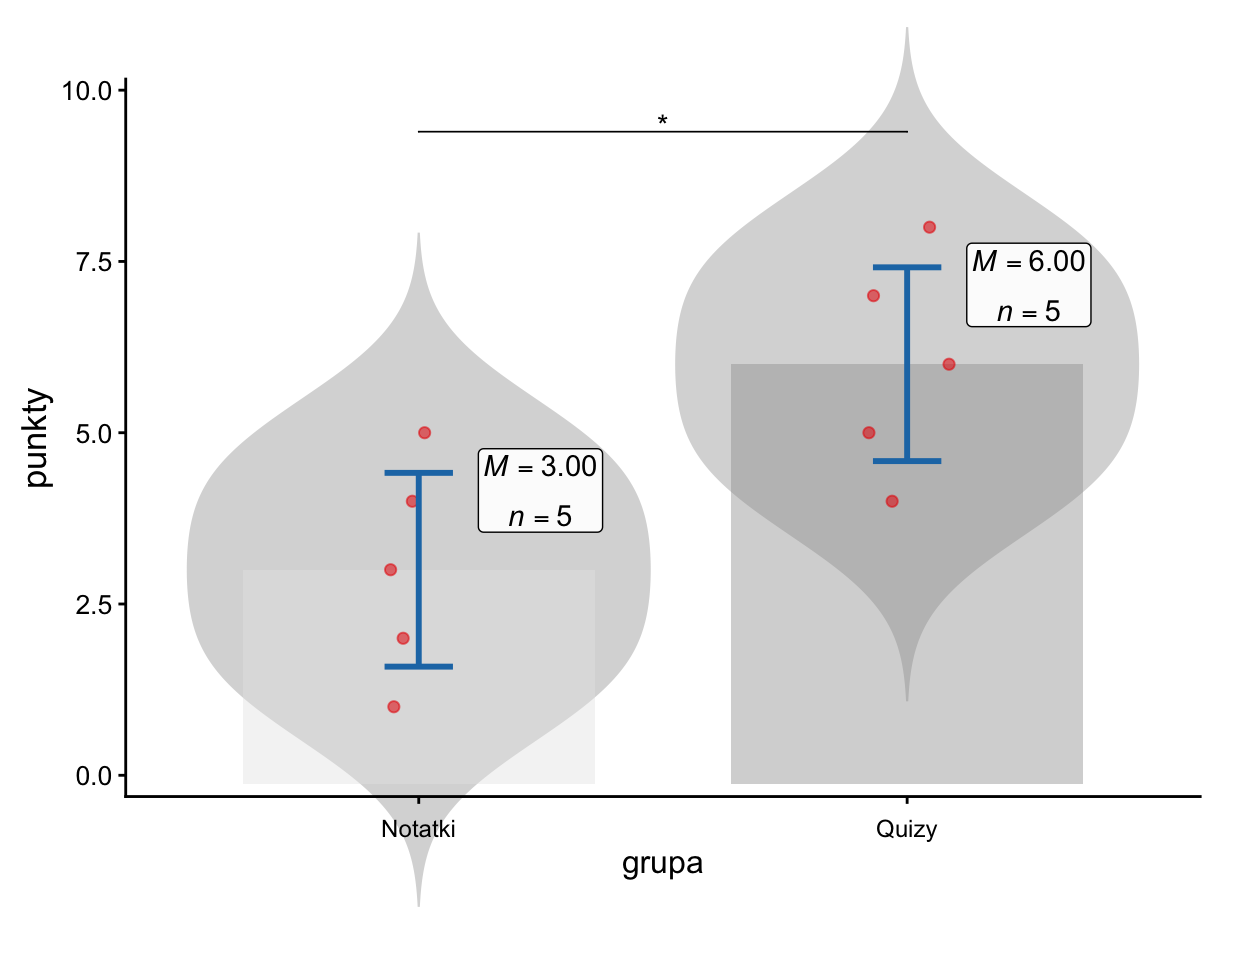
Pięcioro studentów uczyło się z notatek (1, 2, 3, 4, 5 punktów), a pięcioro z quizów (4, 5, 6, 7, 8 punktów). Załóżmy dodatkowo, że z wieloletnich danych prowadzącego wiadomo, iż wariancja wyników tego kolokwium wynosi σ² = 2,5. Celowo wybraliśmy wartość równą wariancji z próby – dzięki temu oba testy dadzą tę samą statystykę i od razu widać, że różnica tkwi wyłącznie w rozkładzie odniesienia.
| Notatki x | x − 3 | (x − 3)² | Quizy x | x − 6 | (x − 6)² |
|---|---|---|---|---|---|
| 1 | 1 − 3 = −2 | 4 | 4 | 4 − 6 = −2 | 4 |
| 2 | 2 − 3 = −1 | 1 | 5 | 5 − 6 = −1 | 1 |
| 3 | 3 − 3 = 0 | 0 | 6 | 6 − 6 = 0 | 0 |
| 4 | 4 − 3 = 1 | 1 | 7 | 7 − 6 = 1 | 1 |
| 5 | 5 − 3 = 2 | 4 | 8 | 8 − 6 = 2 | 4 |
| Σ = 15 | 0 | 10 | Σ = 30 | 0 | 10 |
- Średnie i różnica. 15 / 5 = 3 i 30 / 5 = 6. Różnica 6 − 3 = 3 punkty – licznik obu testów.
- Test z: błąd standardowy ze znanej sigmy. σ² · (1/5 + 1/5) = 2,5 · 0,4 = 1; √1 = 1. Statystyka z = 3 / 1 = 3,00.
- Test z: wartość p. W tablicy rozkładu normalnego dla z = 3,00 pole na lewo wynosi 0,99865. Prawy ogon: 1 − 0,99865 = 0,00135; oba ogony: 2 · 0,00135 = 0,0027 (w R:
2 * pnorm(-3)). Wartość krytyczna dla α = 0,05 to 1,96 (qnorm(0.975)). - Test t: wariancja z próby. W każdej grupie suma kwadratów odchyleń wynosi 10, więc wariancja = 10 / 4 = 2,5. Wariancja połączona: (4 · 2,5 + 4 · 2,5) / 8 = 20 / 8 = 2,5.
- Test t: statystyka. 2,5 · 0,4 = 1; √1 = 1; t = 3 / 1 = 3,00, df = 5 + 5 − 2 = 8.
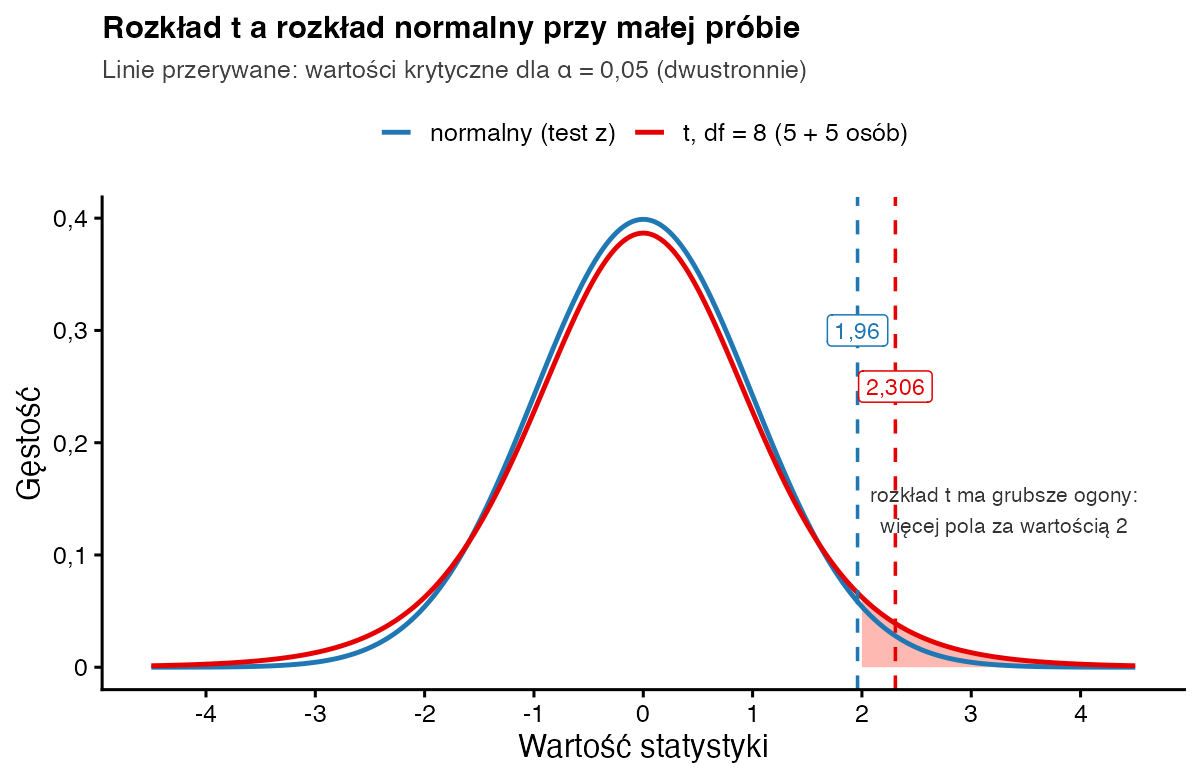
- Test t: wartość p. W tablicy rozkładu t dla df = 8 wartość krytyczna (α = 0,05, dwustronnie) wynosi 2,306 (
qt(0.975, 8)), a nasze 3,00 ją przekracza. Dokładnie: p = 0,017 (2 * pt(-3, 8)). - Porównanie. Ta sama liczba 3,00, a p różni się ponad sześciokrotnie: 0,0027 w teście z i 0,017 w teście t. Rozkład t ma grubsze ogony, bo uwzględnia, że s jest tylko szacunkiem σ.
| Osób w grupie | df testu t | Wartość krytyczna t | p z testu t | Wartość krytyczna z | p z testu z |
|---|---|---|---|---|---|
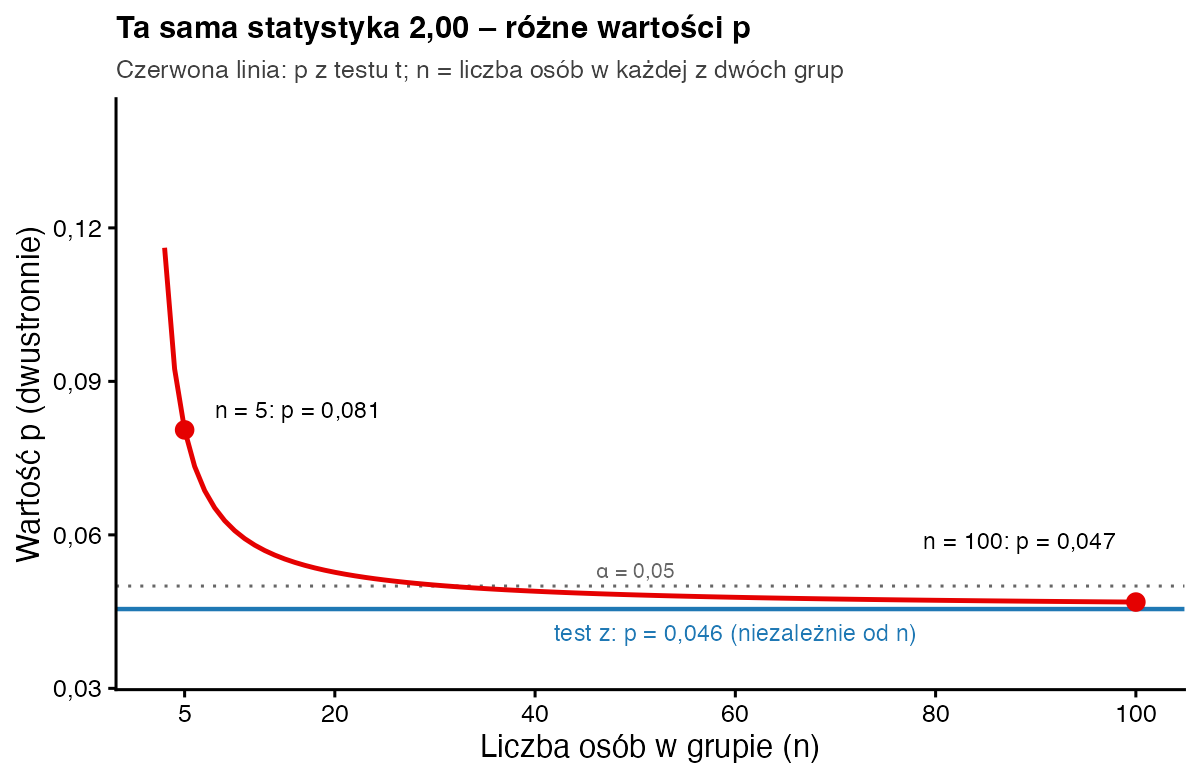
| 5 | 5 + 5 − 2 = 8 | 2,306 | 0,081 (nieistotny) | 1,96 | 0,046 (istotny) |
| 100 | 100 + 100 − 2 = 198 | 1,972 | 0,047 (istotny) | 1,96 | 0,046 (istotny) |
| różnica p | przy n = 5: 0,081 − 0,046 = 0,035; przy n = 100: 0,047 − 0,046 = 0,001 | ||||
Przy pięciu osobach w grupie wybór testu zmienia wniosek: test z „widzi” istotną różnicę, test t – nie. Przy stu osobach oba testy dają praktycznie to samo.
Jak zinterpretować i opisać wynik?
Jeśli odchylenia nie znałeś z góry, raportujesz test t. Wynik z testu z przy małej próbie byłby zbyt optymistyczny: p wyszłoby mniejsze, niż jest naprawdę, więc błędy I rodzaju zdarzałyby się częściej niż w 5% badań. Pamiętaj też, czym jest wartość p: to prawdopodobieństwo wyniku co najmniej tak skrajnego, gdyby metoda nauki nie miała znaczenia, a nie prawdopodobieństwo, że hipoteza zerowa jest prawdziwa.
Zapis w stylu APA: Studenci uczący się z quizów (M = 6,00; SD = 1,58) uzyskali istotnie więcej punktów niż studenci uczący się z notatek (M = 3,00; SD = 1,58), t(8) = 3,00; p = 0,017. Gdyby odchylenie populacji było znane (σ = 1,58), test z dałby z = 3,00; p = 0,003.
Jak policzyć test z i test t w R?
notatki <- c(1, 2, 3, 4, 5)
quizy   <- c(4, 5, 6, 7, 8)
sigma   <- sqrt(2.5)                     # znane odchylenie populacji (z wieloletnich danych)

# 1) „ręcznie”: ta sama różnica, dwa różne mianowniki i rozkłady
roznica <- mean(quizy) - mean(notatki)
s2p <- (4 * var(notatki) + 4 * var(quizy)) / 8          # wariancja połączona z próby
z <- roznica / (sigma * sqrt(1/5 + 1/5)); p_z <- 2 * pnorm(-abs(z))
t <- roznica / sqrt(s2p * (1/5 + 1/5));  p_t <- 2 * pt(-abs(t), df = 8)
round(c(z = z, p_z = p_z, t = t, p_t = p_t), 4)

# 2) gotowe funkcje
DescTools::ZTest(quizy, notatki, sd_pop = sigma)$p.value
t.test(quizy, notatki, var.equal = TRUE)$p.value

# 3) ta sama statystyka 2,00 przy 5 i przy 100 osobach w grupie
round(c(z = 2 * pnorm(-2), t_n5 = 2 * pt(-2, 8), t_n100 = 2 * pt(-2, 198)), 4)
round(c(z = qnorm(0.975), t_df8 = qt(0.975, 8), t_df198 = qt(0.975, 198)), 3)
Wynik w konsoli R:
     z    p_z      t    p_t
3.0000 0.0027 3.0000 0.0171
[1] 0.002699796
[1] 0.01707168
     z   t_n5 t_n100
0.0455 0.0805 0.0469
      z   t_df8 t_df198
  1.960   2.306   1.972
Rachunek „ręczny” i gotowe funkcje dają to samo: p = 0,0027 dla z i 0,0171 dla t. W podstawowym R nie ma funkcji do testu z, dlatego użyliśmy ZTest() z pakietu DescTools.
Od ilu osób test t i test z dają to samo?
Nie ma jednej granicy, ale reguła „od 30 osób można używać z” pochodzi z czasów, gdy tablice rozkładu t były krótkie. Na rys. 3 widać, że przy 30 osobach w grupie p z testu t to 0,050, a z testu z – 0,046. Różnica jest mała, ale przy wyniku „na granicy” może zmienić wniosek. Programy liczą rozkład t dla dowolnych stopni swobody, więc nie ma powodu przechodzić na z – test t jest poprawny przy każdej liczebności, a z tylko w przybliżeniu.
Najczęstsze błędy
- Liczenie testu z z odchyleniem policzonym z próby. To w rzeczywistości test t, tylko z błędnym rozkładem odniesienia.
- Używanie wartości krytycznej 1,96 przy kilku osobach w grupie. Dla df = 8 granica wynosi 2,306 (a w teście jednostronnym – 1,860).
- Przekonanie, że test t „wymaga małej próby”. Test t jest poprawny przy każdej liczebności.
- Mylenie testu z dla średnich z wynikiem standaryzowanym z pojedynczej osoby – to dwie różne rzeczy o tej samej literze.
- Pisanie „przyjęto H0”, gdy p > 0,05. Poprawnie: „brak podstaw do odrzucenia H0”.
Bibliografia
- Student. (1908). The probable error of a mean. Biometrika, 6(1), 1–25. https://doi.org/10.1093/biomet/6.1.1
- Zabell, S. L. (2008). On Student’s 1908 article “The probable error of a mean”. Journal of the American Statistical Association, 103(481), 1–7. https://doi.org/10.1198/016214508000000030
- King, B. M., & Minium, E. W. (2009). Statystyka dla psychologów i pedagogów. Wydawnictwo Naukowe PWN.
- Field, A., Miles, J., & Field, Z. (2012). Discovering statistics using R. SAGE.
- Hryniewicz, K., & Milewska, A. (2023). SZTOS: System Zautomatyzowanego Tworzenia Opisu Statystycznego [Oprogramowanie]. SZTOS IT. https://sztos-it.com/
Zobacz też
- Słownik wzorówRozkład t Studenta i stopnie swobody
- Słownik wzorówTest t dla jednej próby
- Słownik wzorówWynik standaryzowany z
- Słownik wzorówRozkład normalny
- PoradnikTest statystyczny – na czym polega
- Słownik wzorówSłownik wzorów statystycznych – wszystkie hasła
Potrzebujesz pomocy z analizą do pracy dyplomowej?
Policzymy Twoje wyniki, przygotujemy tabele, wykresy i opis w standardzie APA, który wykorzystasz w swojej pracy. Pomagamy jak statystyk i redaktor – autorem pracy zostajesz Ty. Konsultacja i wycena są bezpłatne.