

Jak wybrać test statystyczny – drzewko decyzyjne i tabela
Test statystyczny wybierasz na podstawie trzech rzeczy: typu zmiennej, liczby porównywanych grup i tego, czy w grupach są te same osoby. Typowe pytanie z pracy dyplomowej: mam dwie grupy i wyniki z ankiety – test t czy test U Manna-Whitneya?
W prostych słowachNie ma jednego „najlepszego” testu. Test dobierasz do pytania badawczego i do danych, a nie do tego, który da mniejsze p. Najpierw ustalasz, co porównujesz i jakiego typu jest wynik, potem sprawdzasz założenia. Gdy założenia są spełnione, bierzesz test parametryczny, a gdy nie – jego nieparametryczny odpowiednik.
Trzy pytania, które wybierają test za Ciebie
- Jakiego typu jest wynik (zmienna zależna)? Ilościowy (punkty, czas, wynik skali), porządkowy (pojedyncze pytanie 1–5, miejsce w rankingu) albo kategorialny (zdał/nie zdał, kierunek studiów).
- Co porównujesz? Dwie grupy, trzy i więcej grup, albo szukasz związku dwóch zmiennych.
- Czy osoby się powtarzają? Różne osoby w grupach to próby niezależne. Te same osoby mierzone dwa razy (przed i po warsztatach) albo dobrane pary to próby zależne.
Dopiero na końcu pytasz o założenia: czy rozkład w każdej grupie jest zbliżony do normalnego i czy wariancje są podobne. Jak to sprawdzić, pokazujemy we wpisie jak sprawdzić normalność rozkładu, a co zrobić, gdy wynik jest zły – w poradniku brak normalności – co robić. Ogólną logikę każdego testu, czyli hipotezy i wartość p, opisuje wpis test statystyczny.
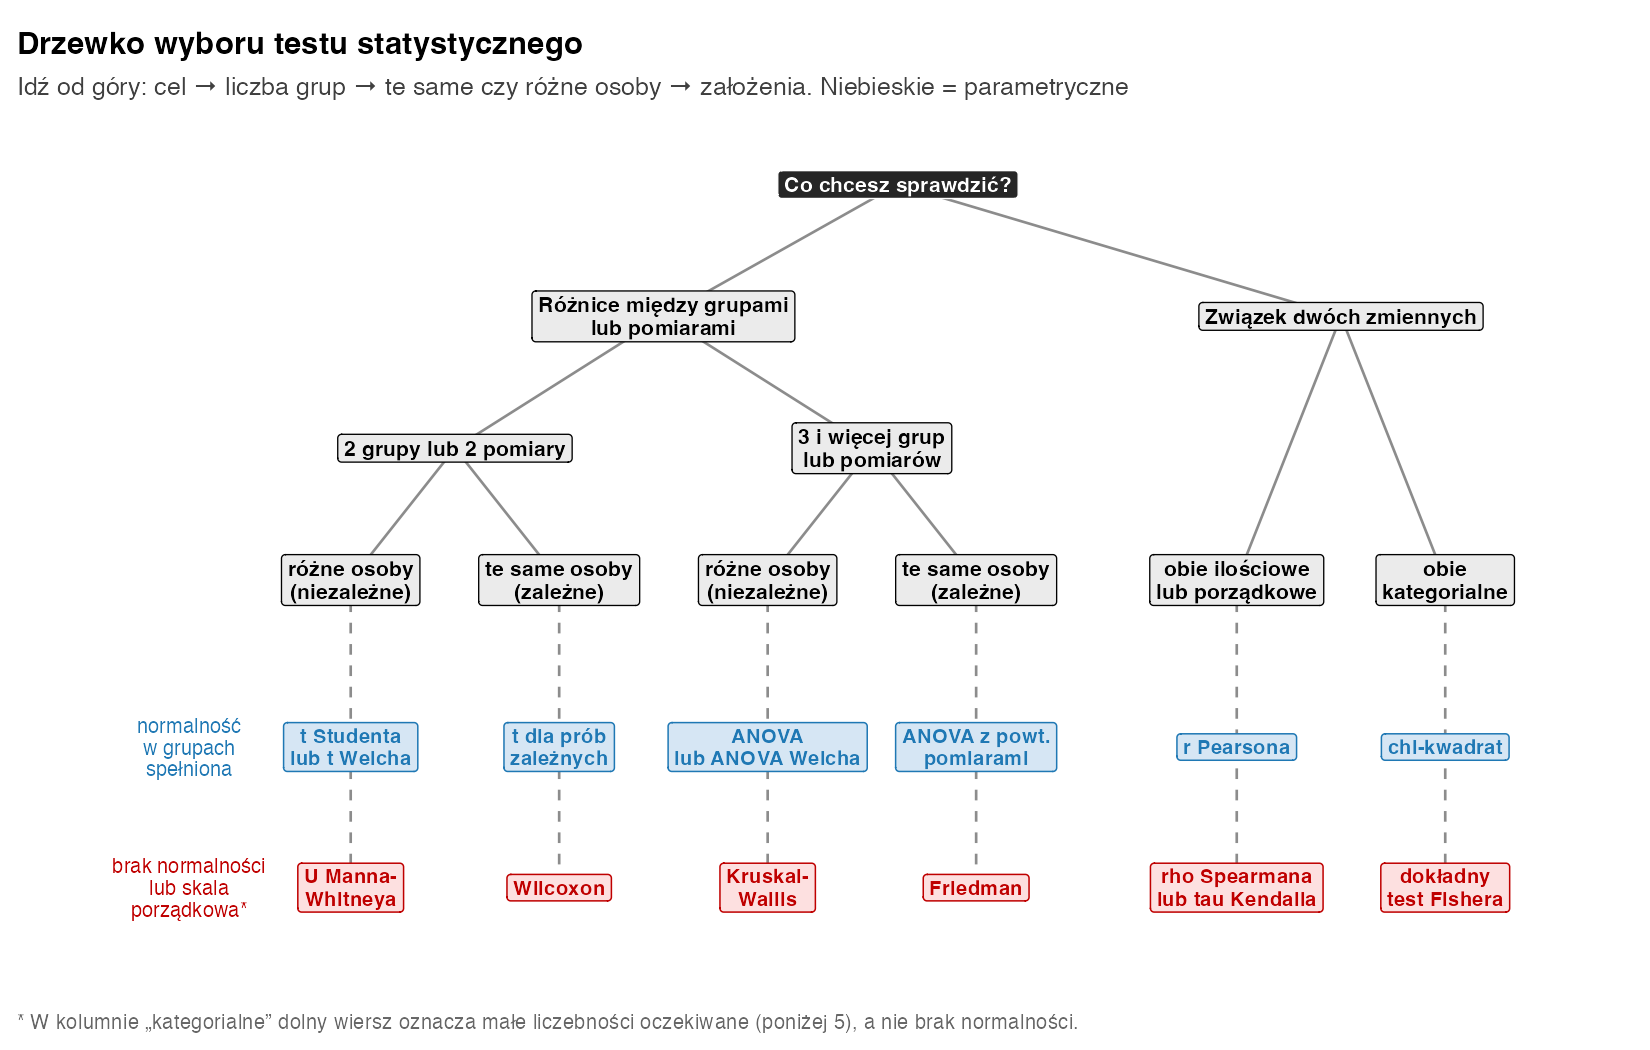
Tabela decyzyjna – który test wybrać?
Znajdź wiersz, który opisuje Twój układ badania, i kolumnę pasującą do typu wyniku. Każda nazwa prowadzi do hasła w słowniku wzorów z przykładem krok po kroku.
| Układ badania | Wynik ilościowy, założenia spełnione (test parametryczny) | Wynik porządkowy lub brak normalności (test nieparametryczny) | Wynik kategorialny |
|---|---|---|---|
| Jedna grupa a norma lub wartość z literatury | test t dla jednej próby | test Wilcoxona dla jednej próby | chi-kwadrat zgodności, test dwumianowy |
| Dwie grupy różnych osób | test t Studenta, test t Welcha | test U Manna-Whitneya | chi-kwadrat, dokładny test Fishera |
| Dwa pomiary tych samych osób | test t dla prób zależnych | test Wilcoxona | test McNemara |
| Trzy i więcej grup różnych osób | jednoczynnikowa ANOVA, ANOVA Welcha | test Kruskala-Wallisa + test Dunna | chi-kwadrat + V Cramera |
| Trzy i więcej pomiarów tych samych osób | ANOVA z powtarzanymi pomiarami | test Friedmana | test Q Cochrana |
| Dwa czynniki naraz (np. metoda nauki × płeć) | dwuczynnikowa ANOVA | – | regresja logistyczna |
| Związek dwóch zmiennych | korelacja Pearsona | korelacja Spearmana, tau Kendalla | chi-kwadrat + phi |
| Przewidywanie wyniku z kilku zmiennych | regresja liniowa | regresja z bootstrapem | regresja logistyczna |
Pełne przykłady z danymi, założeniami i gotowym opisem znajdziesz we wpisach: test t – przykład, ANOVA – przykład i chi-kwadrat – przykład. Jak wygląda gotowy opis w raporcie, pokazuje przykładowy raport z testem U.
Test parametryczny czy nieparametryczny?
- Normalność sprawdzasz w każdej grupie osobno (albo na resztach modelu), a nie na całej zmiennej. Szczegóły: testy parametryczne.
- Nierówne wariancje to nie powód do testu nieparametrycznego. Wystarczy test t Welcha lub ANOVA Welcha (Delacre i in., 2017).
- Duże grupy wybaczają więcej. Przy kilkudziesięciu osobach w grupie test t i ANOVA dobrze znoszą umiarkowaną skośność (Lumley i in., 2002; Fagerland, 2012).
- Pojedyncze pytanie Likerta to skala porządkowa – tu lepiej sprawdzi się test rangowy. Średnia z kilku pytań skali bywa traktowana jak wynik ilościowy; więcej we wpisie o analizie skali Likerta.
- Testy rangowe to nie „testy median”. Test U porównuje, czy wyniki jednej grupy mają tendencję do bycia wyższymi niż w drugiej. Przegląd: testy nieparametryczne.
Mini-przykład: test t czy test U na tych samych danych?
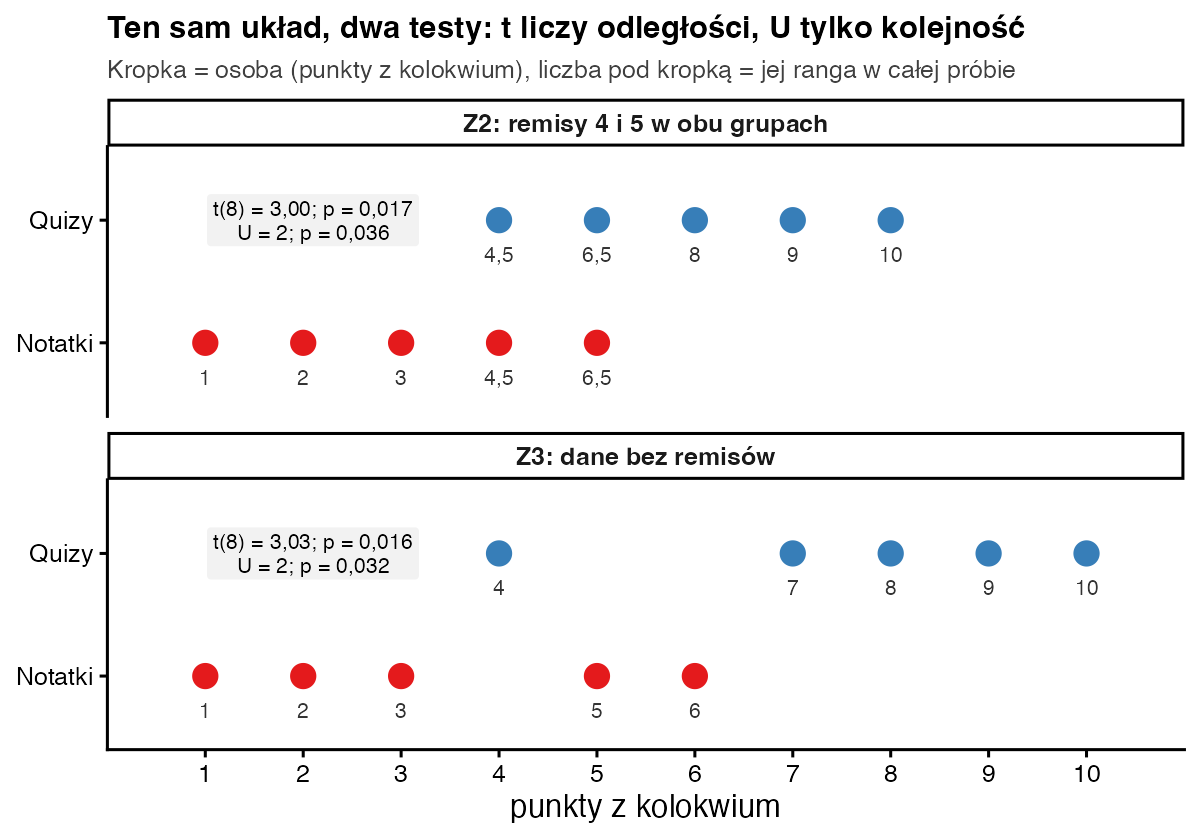
Weźmy punkty z kolokwium dwóch grup po 5 osób: uczących się z notatek i z quizów. Zbiór Z2 ma remisy (wyniki 4 i 5 są w obu grupach), zbiór Z3 – nie ma. Test t korzysta z dokładnych odległości między wynikami, a test U tylko z ich kolejności, czyli rang.
| Zbiór | Notatki | Quizy | Suma rang Notatki / Quizy | Test t | Test U |
|---|---|---|---|---|---|
| Z2 | 1, 2, 3, 4, 5 | 4, 5, 6, 7, 8 | 17 / 38 | t(8) = 3,00; p = 0,017 | U = 2; p = 0,036* |
| Z3 | 1, 2, 3, 5, 6 | 4, 7, 8, 9, 10 | 17 / 38 | t(8) = 3,03; p = 0,016 | U = 2; p = 0,032 |
| * Remisy w Z2 sprawiają, że p testu U pochodzi z przybliżenia rozkładem normalnym; w Z3 jest dokładne. | |||||
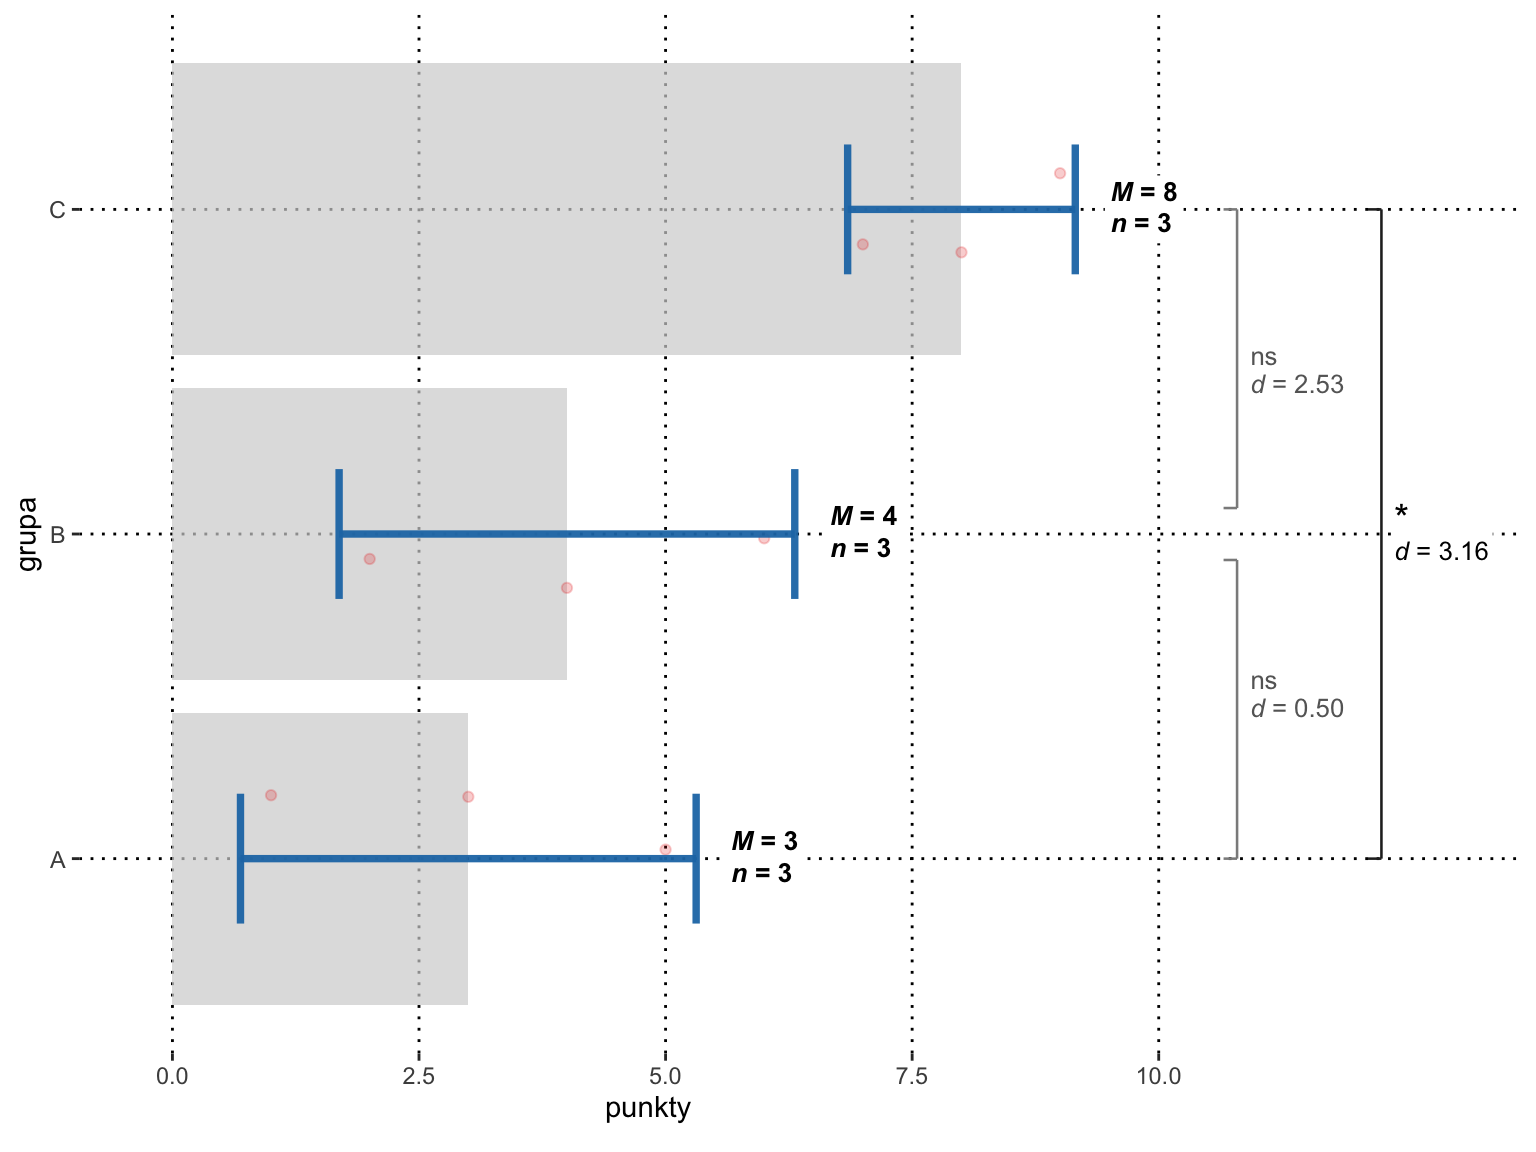
W obu zbiorach sumy rang są takie same (17 i 38), więc statystyka testu U też jest ta sama (U = 2), choć same wyniki się różnią. Oba testy dają p < 0,05, ale test t ma mniejsze p, bo wykorzystuje więcej informacji. Przy trzech grupach ta różnica bywa ważniejsza. Na danych Z6 (grupy ćwiczeniowe A, B, C po 3 osoby) ANOVA daje F(2, 6) = 7,00; p = 0,027, a test Kruskala-Wallisa H = 5,60; p = 0,061. Przy tak małych grupach test rangowy ma za małą moc. Dlatego test wybierasz przed spojrzeniem na wyniki, na podstawie założeń.
Jak sprawdzić założenia i porównać testy w R?
# Wybór testu w praktyce: dwie grupy niezależne (Z2, Z3) i trzy grupy (Z6)
notatki <- c(1, 2, 3, 4, 5); quizy <- c(4, 5, 6, 7, 8)          # Z2: punkty z kolokwium
punkty  <- c(notatki, quizy)
grupa   <- factor(rep(c("Notatki", "Quizy"), each = 5))

# Krok 1: założenia – normalność w KAŻDEJ grupie i równość wariancji
tapply(punkty, grupa, function(x) round(shapiro.test(x)$p.value, 3))
round(car::leveneTest(punkty ~ grupa, center = mean)$`Pr(>F)`[1], 3)

# Krok 2: test parametryczny i jego nieparametryczny odpowiednik
round(t.test(quizy, notatki, var.equal = TRUE)$p.value, 3)          # test t
u <- suppressWarnings(wilcox.test(notatki, quizy))                  # test U (R pisze W)
c(U = unname(u$statistic), p = round(u$p.value, 3))                 # remisy -> p przybliżone

# Z3: to samo pytanie, dane bez remisów (dokładne p testu U)
n3 <- c(1, 2, 3, 5, 6); q3 <- c(4, 7, 8, 9, 10)
round(c(t = t.test(q3, n3, var.equal = TRUE)$p.value, U = wilcox.test(n3, q3)$p.value), 3)

# Z6: trzy grupy ćwiczeniowe – ANOVA i test Kruskala-Wallisa
w <- c(1, 3, 5, 2, 4, 6, 7, 8, 9); g <- factor(rep(c("A", "B", "C"), each = 3))
summary(aov(w ~ g))
kruskal.test(w ~ g)
Wynik w konsoli R:
Notatki   Quizy
  0.967   0.967
[1] 1
[1] 0.017
    U     p
2.000 0.036
    t     U
0.016 0.032
            Df Sum Sq Mean Sq F value Pr(>F)
g            2     42      21       7  0.027 *
Residuals    6     18       3
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1

	Kruskal-Wallis rank sum test

data:  w by g
Kruskal-Wallis chi-squared = 5.6, df = 2, p-value = 0.06081
Najczęstsze pytania
Jaki test do porównania dwóch grup?
Gdy grupy tworzą różne osoby, a wynik jest ilościowy – test t Studenta albo Welcha. Gdy wynik jest porządkowy albo rozkład w małej grupie jest wyraźnie skośny – test U Manna-Whitneya. Gdy porównujesz te same osoby przed i po – test t dla prób zależnych albo test Wilcoxona.
Czy mogę zrobić kilka testów t zamiast ANOVA?
Lepiej nie. Przy trzech grupach to trzy porównania, a każde niesie ryzyko fałszywego alarmu, więc łączne ryzyko błędu I rodzaju rośnie. Najpierw wykonaj ANOVA, a porównania parami – z poprawką, np. Holma albo testem Tukeya.
Ile osób musi być w grupie, żeby użyć testu t?
Nie ma sztywnej granicy. Test t działa nawet przy kilku osobach, jeśli rozkłady są zbliżone do normalnego, ale wtedy łatwo przeoczy prawdziwą różnicę. Liczebność próby planuj z góry – podpowiadamy, jak to zrobić, we wpisie ile osób przebadać do pracy magisterskiej.
Co napisać, gdy wynik jest nieistotny?
Napisz, że nie ma podstaw do odrzucenia hipotezy zerowej, i podaj wielkość efektu. Brak istotności nie dowodzi, że grupy są takie same. Podobnie istotna korelacja nie dowodzi, że jedna zmienna jest przyczyną drugiej.
Najczęstsze błędy
- Wybór testu po sprawdzeniu, który daje mniejsze p.
- Test dla prób niezależnych przy pomiarze tych samych osób przed i po.
- Sprawdzanie normalności na całej zmiennej zamiast w każdej grupie.
- Seria testów t zamiast ANOVA i brak poprawki na wielokrotne porównania.
- Test chi-kwadrat przy bardzo małych liczebnościach oczekiwanych zamiast testu Fishera.
Bibliografia
- Mann, H. B., & Whitney, D. R. (1947). On a test of whether one of two random variables is stochastically larger than the other. The Annals of Mathematical Statistics, 18(1), 50–60. https://doi.org/10.1214/aoms/1177730491
- Kruskal, W. H., & Wallis, W. A. (1952). Use of ranks in one-criterion variance analysis. Journal of the American Statistical Association, 47(260), 583–621. https://doi.org/10.1080/01621459.1952.10483441
- Lumley, T., Diehr, P., Emerson, S., & Chen, L. (2002). The importance of the normality assumption in large public health data sets. Annual Review of Public Health, 23, 151–169. https://doi.org/10.1146/annurev.publhealth.23.100901.140546
- Fagerland, M. W. (2012). t-tests, non-parametric tests, and large studies – a paradox of statistical practice? BMC Medical Research Methodology, 12, 78. https://doi.org/10.1186/1471-2288-12-78
- Delacre, M., Lakens, D., & Leys, C. (2017). Why psychologists should by default use Welch’s t-test instead of Student’s t-test. International Review of Social Psychology, 30(1), 92–101. https://doi.org/10.5334/irsp.82
- Field, A., Miles, J., & Field, Z. (2012). Discovering statistics using R. SAGE.
- King, B. M., & Minium, E. W. (2009). Statystyka dla psychologów i pedagogów. Wydawnictwo Naukowe PWN.
- Hryniewicz, K., & Milewska, A. (2023). SZTOS: System Zautomatyzowanego Tworzenia Opisu Statystycznego [Oprogramowanie]. SZTOS IT. https://sztos-it.com/
Zobacz też
- PoradnikTesty parametryczne
- PoradnikTesty nieparametryczne
- Słownik wzorówTest chi-kwadrat
- PoradnikJak sprawdzić normalność rozkładu – Q-Q, Shapiro-Wilk
- PoradnikTest t Studenta – przykład
- Przykładowy raportTest t Studenta
Potrzebujesz pomocy z analizą do pracy dyplomowej?
Policzymy Twoje wyniki, przygotujemy tabele, wykresy i opis w standardzie APA, który wykorzystasz w swojej pracy. Pomagamy jak statystyk i redaktor – autorem pracy zostajesz Ty. Konsultacja i wycena są bezpłatne.